「相場の勘」をデータで確かめたくて。85銘柄×17セクターからTechnical Hunter V4を作るまで
最近、個人開発で日本株のテクニカル分析システム 「Technical Hunter」 を作っています。
最初から大きなシステムを作ろうと思っていたわけではありません。
きっかけは、とても単純な疑問でした。
「Supply / Demand Zoneって、本当に銘柄によって効き方が違うのでは?」
チャートを見ていると、価格帯で何度も反応する銘柄がある一方、同じようなゾーンを簡単に突き抜けてしまう銘柄もあります。
それを「なんとなくそう見える」で終わらせず、データで確かめてみたくなったことから、この研究が始まりました。
まずは「未来を見ない」Supply / Demandを作る
最初に取り組んだのは、Supply / Demand Zoneそのものの再構築です。
チャート上では過去を振り返れば簡単に「ここがゾーンだった」と言えます。
しかし、バックテストで未来の値動きを使ってゾーンを確定してしまえば、結果は簡単に良くなってしまいます。
そこで、
- 小さなローソク足が2〜5本集まったBase
- そこから一定以上の勢いで離れるDeparture
- Departureが確認された翌営業日からZoneを有効化
- Demandは終値が下抜けたら無効
- Supplyは終値が上抜けたら無効
という形で、その時点で本当に知ることのできた情報だけを使うcausalなロジックにしました。
この部分はかなり地味ですが、個人的には一番大切にしているところです。
「良い結果を出す」より前に、まず「検証として正しい状態を作る」。
実務のデータ分析でも同じだと感じています。
50銘柄で検証したら、「銘柄ごとに違うかもしれない」が見えてきた
最初の研究対象は、日本株50銘柄でした。
Demand Zoneへの接近やTouch、その後の5日・20日・60日のリターンを調べていくと、
「Demandは比較的反応するけれどSupplyは弱い」
「Supply側の方が明らかに機能している」
といった銘柄差が見え始めました。
そこで一度、「S/D適性スコア」のようなものを作ってみました。
ただ、ここで問題が出ます。
条件を複数重ねて集計していたため、サンプル数が「6.5件」のような疑似的な数字になってしまったり、イベント数が少ない銘柄の大きな値動きがランキング上位に来てしまったりしました。
一見きれいなランキングが出ても、
「これは本当に信頼していいのか?」
という疑問が残りました。
むしろ、この違和感を持てたことが次の改善につながりました。
「50銘柄だけでいいの?」から、17セクター×5銘柄へ
次に考えたのが、ユニバースの問題です。
50銘柄だけで分析していると、そもそも選んだ銘柄に偏りがある可能性があります。
そこでJ-Quantsの銘柄情報を使い、TOPIX-17の各セクターから、直近の流動性が高い銘柄を5社ずつ自動選抜する仕組みを作りました。
結果、
17セクター × 5銘柄 = 85銘柄
のセクターバランス型ユニバースができました。
選抜にはSupply / Demandの成績を一切使わず、流動性だけを利用しています。
先に「S/Dが効いた銘柄」を選んでしまうと、その後の検証も良く見えてしまうからです。
85銘柄、約2年の日足データを取得し、最終的には
- 41,130行
- Supply / Demand Zone 1,386件
- Demand Zone 824件
- Supply Zone 562件
の研究用データセットになりました。
V2では「実際のイベント1回 = 1件」に戻した
次に作ったS/D Suitability V2では、最初のランキング方法も見直しました。
Touchを独立したイベントとして数え、
1回のTouch = 1サンプル
にしました。
さらに、
- Demand / Supplyを別々に評価
- 少数サンプルの結果をShrinkageで小さくする
- Bootstrapで95%信頼区間を計算
- IS / OOSで安定しているかを見る
- MFE / MAEも暴れにくい指標へ変更
- 片側のデータがない銘柄がランキング上有利にならないよう修正
といった改善を入れています。
ここで興味深かったのが、「この銘柄はS/Dが得意」という一言では説明しきれなかったことです。
セクターによって「Demandが得意」「Supplyが得意」が違った
85銘柄を17セクターでまとめてみると、かなり非対称な傾向が見えてきました。
例えば今回のValidation期間では、
電機・精密や鉄鋼・非鉄ではDemand側が強い
一方で、
自動車・輸送機や小売などではSupply側の反応が比較的強い
という結果になりました。
逆に、今回のロジックではDemand / Supplyの両方があまり機能していないセクターもあります。
つまり、
「Supply / Demandという手法が効くかどうか」ではなく、
「どのセクターの、どちら側のZoneが得意なのか」
を見る必要があるのではないか。
ここが今回の研究で一番面白かった発見でした。
もちろん、まだ約2年のデータしかなく、すでに何度も確認している期間なので、ここを「最終的なOOS」と呼ぶことはできません。
今はあくまでValidation。
ここでルールを固定し、将来の新しいデータで再確認する必要があります。
そしてTechnical Hunter V4へ
この結果を、最終的に分析ツールへ組み込みました。
それが現在の Technical Hunter V4 です。
従来のV3では、
Supply / Demandの現在位置やTouch、MAなどからTechnical Scoreを計算していました。
V4ではそこに、
Sector × Demand / Supply Suitability
というContextを追加しています。
例えばDemandが得意なセクターならDemand側のEvidenceを少し強く評価し、Supplyがあまり機能していないセクターならSupplyによるペナルティを弱める。
逆にSupply反応が強いセクターでは、Supplyへの接近をより強く警戒します。
個別銘柄の適性も利用しますが、現在はまだサンプル数が少ないため、銘柄単独の結果を強く使わず、セクター情報を主体にしています。
85銘柄から「今日見るべき銘柄」を探す
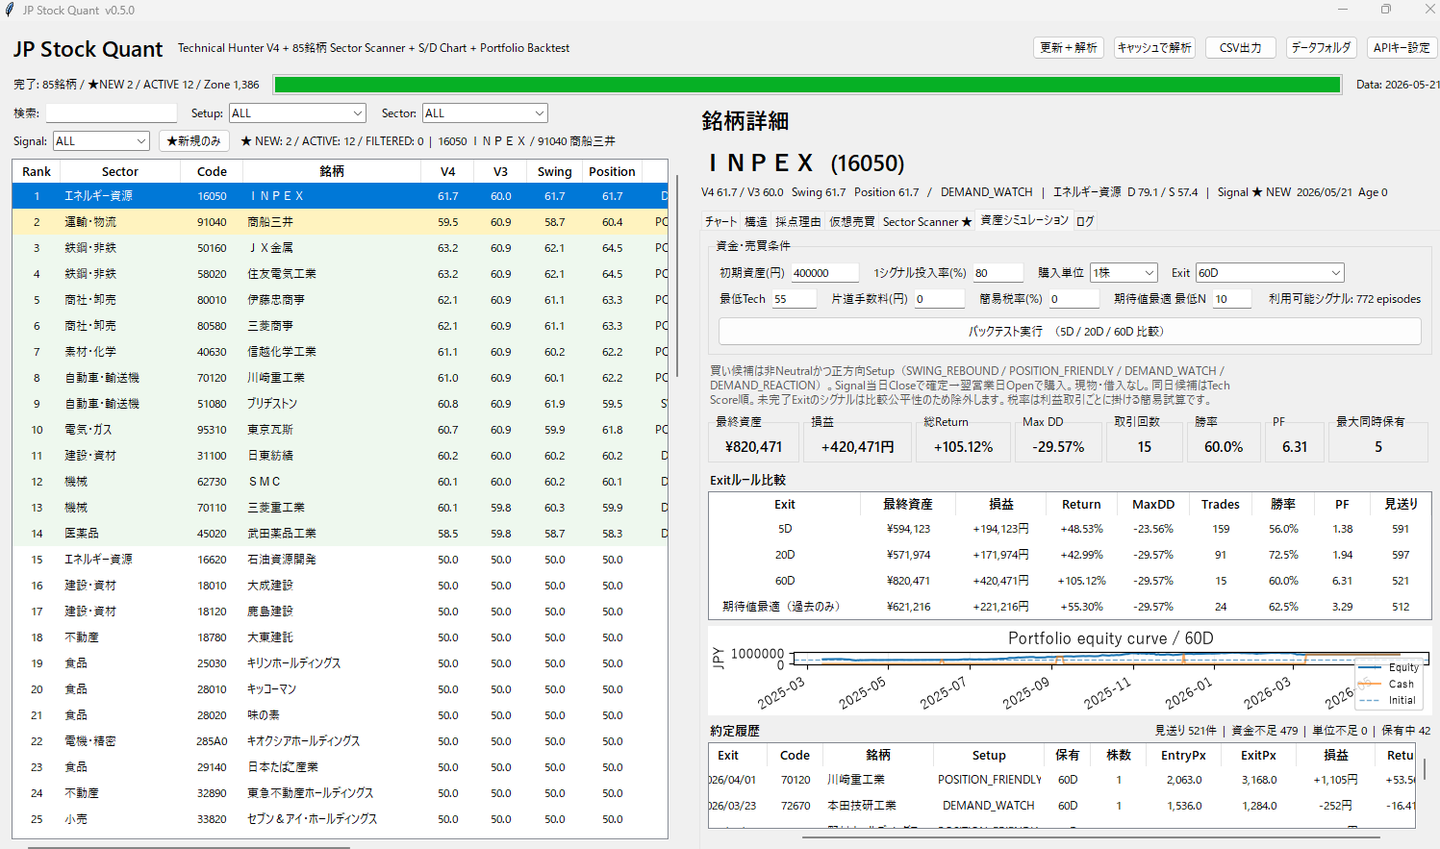
TradingView版だけでなく、WindowsアプリにもV4を実装しました。
現在は85銘柄を一括で解析し、
- ★ NEW
- ACTIVE
- FILTERED
を自動判定します。
さらにSector Scannerを作り、
「今日はどのセクターから新しいシグナルが出ているか」
を一覧で確認できるようにしました。
85枚のチャートを1枚ずつ確認するのではなく、
「今日は電機・精密からNEWが2銘柄出ている」
といったところから調査を始められます。
私はこの形をかなり気に入っています。
なぜなら、これは「売買を自動化するシステム」というより、
大量の情報の中から、人間が詳しく見るべき対象を絞り込むシステム
だからです。
作っていて改めて感じたこと
今回の個人開発では、コードを書くこと以上に、
「この数字は本当に信じていいのか?」
と何度も問い直したことが印象に残っています。
ランキングができたら終わりではなく、
サンプル数がおかしい。
欠損値が有利になっている。
少数データに引っ張られている。
同じデータを何度も見たので、もうOOSとは呼べない。
そういった問題を一つずつ見つけて直していく。
その過程は、普段データサイエンスの仕事で行っている、
仮説を立てる → データを見る → 違和感を見つける → 検証方法を直す → もう一度確かめる
という流れそのものだと感じました。
最初は「このチャートパターン、効いていそう」という小さな疑問でした。
そこから、
50銘柄の検証、
85銘柄への拡張、
セクター分析、
統計的な信頼性の改善、
TradingViewへの移植、
そしてWindowsアプリ化まで進みました。
まだ研究途中です。
むしろ、ここから先の新しいデータで本当に再現するのかを見るところが一番重要です。
それでも、
曖昧だった感覚を、検証できる形に変えていく。
このプロセスそのものが、私がデータ分析を面白いと思う理由なのかもしれません。