こんにちは!株式会社Freedoming人事担当の平区です🌈
前回公開した「AWS超入門【運用編・前編】」は読んでいただけましたでしょうか?
「動かす・変える・治す」という運用の基本や、「障害対応は上流から切り分ける」という鉄則をお届けしました。
今回は、さらに一歩踏み込んだ【後編(実践編)】をお届けします!
現場で本当にアラートが鳴ったとき、インフラエンジニアはどう画面を見て、どう動くのか? 板矢直伝のトラブルシューティングを、ぜひ疑似体験してみてください!
🚨 【実践】突然のアラート!あなたならどう動く?
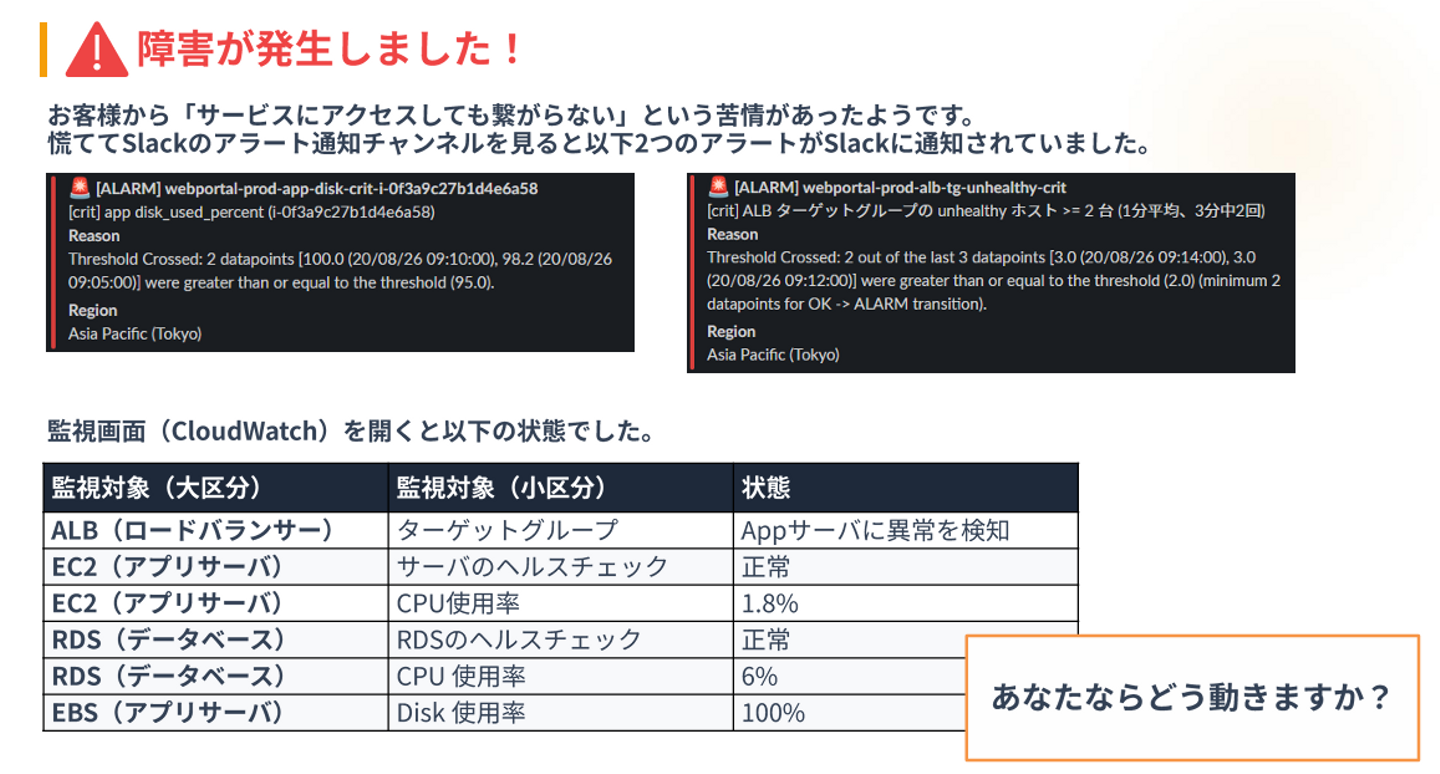
さて、ここからは実践編です。
ある日突然、お客様から「サービスにアクセスしても繋がらない!」という苦情が入りました。
慌ててSlackのアラート通知チャンネルを開くと、以下の2つのアラートが届いています。
[ALARM] app disk_used_percent (Disk使用率が95%超え)[ALARM] ALB ターゲットグループの unhealthy ホスト >= 2台
さらに、CloudWatchの監視画面を開くとこんな状態でした。
- ALB(ロードバランサー): Appサーバに異常を検知
- EC2(アプリサーバ): サーバのヘルスチェックは「正常」、CPU使用率 1.8%
- RDS(データベース): 正常、CPU使用率 11%
- EBS(アプリサーバのディスク): Disk使用率 100%
さあ、あなたならどう動きますか?
🛠️ 障害対応の3ステップ
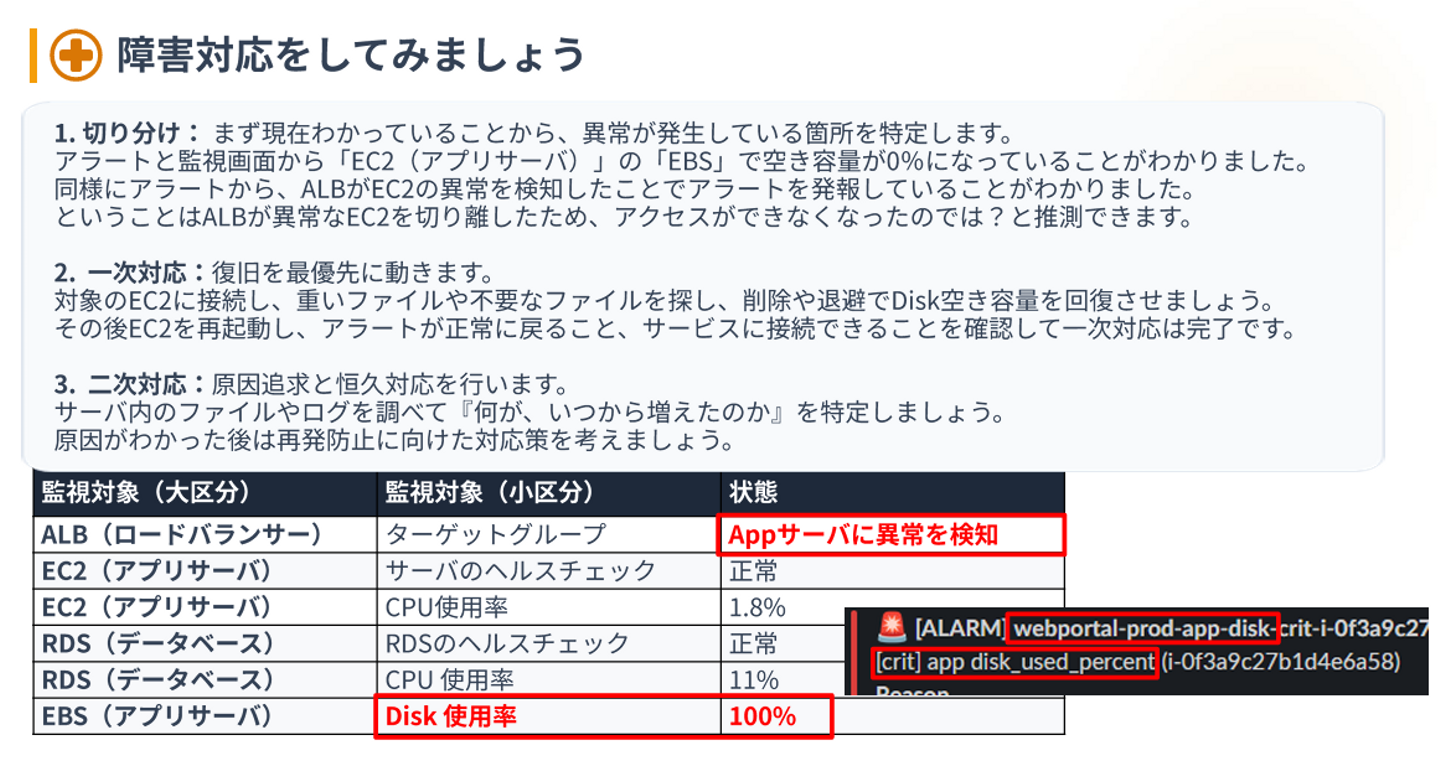
前編でお話しした「まず復旧」「上流から切り分ける」を思い出してください。 正解の動き方は、この3ステップです。
1. 切り分け(状況の特定)
監視画面を見ると、アプリサーバのディスク(EBS)の空き容量が0%(使用率100%)になっています。 そしてALBが「このEC2はおかしい!」と異常を検知していました。 つまり、『ALBが異常なEC2を切り離したため、外からアクセスできなくなっていた』という状況が推測できます。
2. 一次対応(復旧最優先!)
何が原因かをじっくり調べる前に、まずはサービスを復旧させます。 対象のEC2に接続し、不要なファイルや肥大化した古いログを削除・退避してディスクの空き容量を回復させます。その後EC2を再起動し、アラートが正常に戻ってWebサイトに繋がることを確認すれば一次対応は完了です。
3. 二次対応(原因究明と再発防止)
息をつくのはここまで。復旧した後に、じっくりログを調べて「何が、いつから増えてパンクしたのか」を突き止めます。 ログローテーションの設定漏れだったのか、誰かが巨大なファイルを置きっぱなしにしたのか……原因に合わせた恒久対策を打ちましょう。
🔍 なぜEC2は「正常」だったのか?(監視の落とし穴)
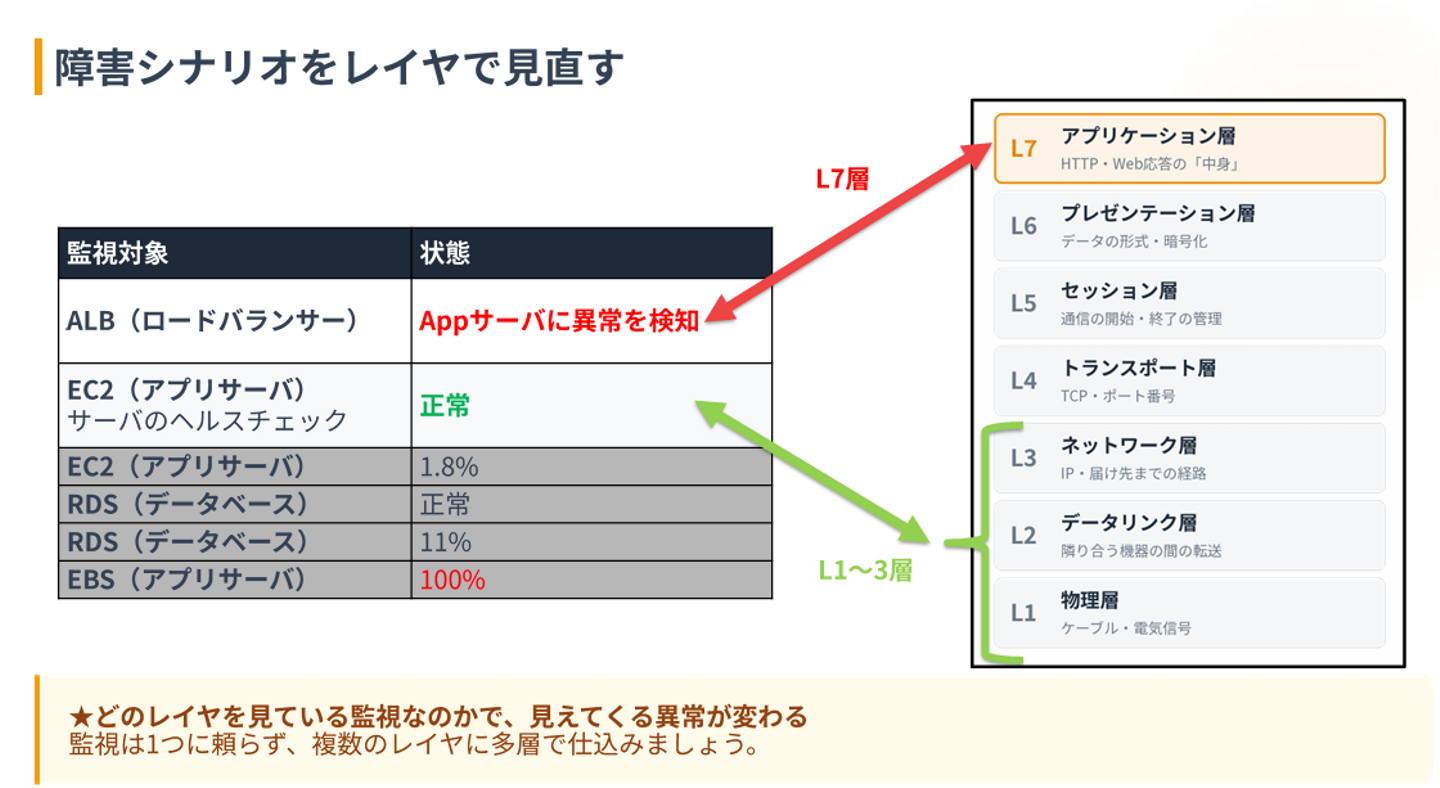
ここで、鋭いエンジニアなら一つの違和感に気づいたはずです。
「ディスクが100%パンクしていたのに、なんでEC2のヘルスチェックは『正常』だったの?」と。
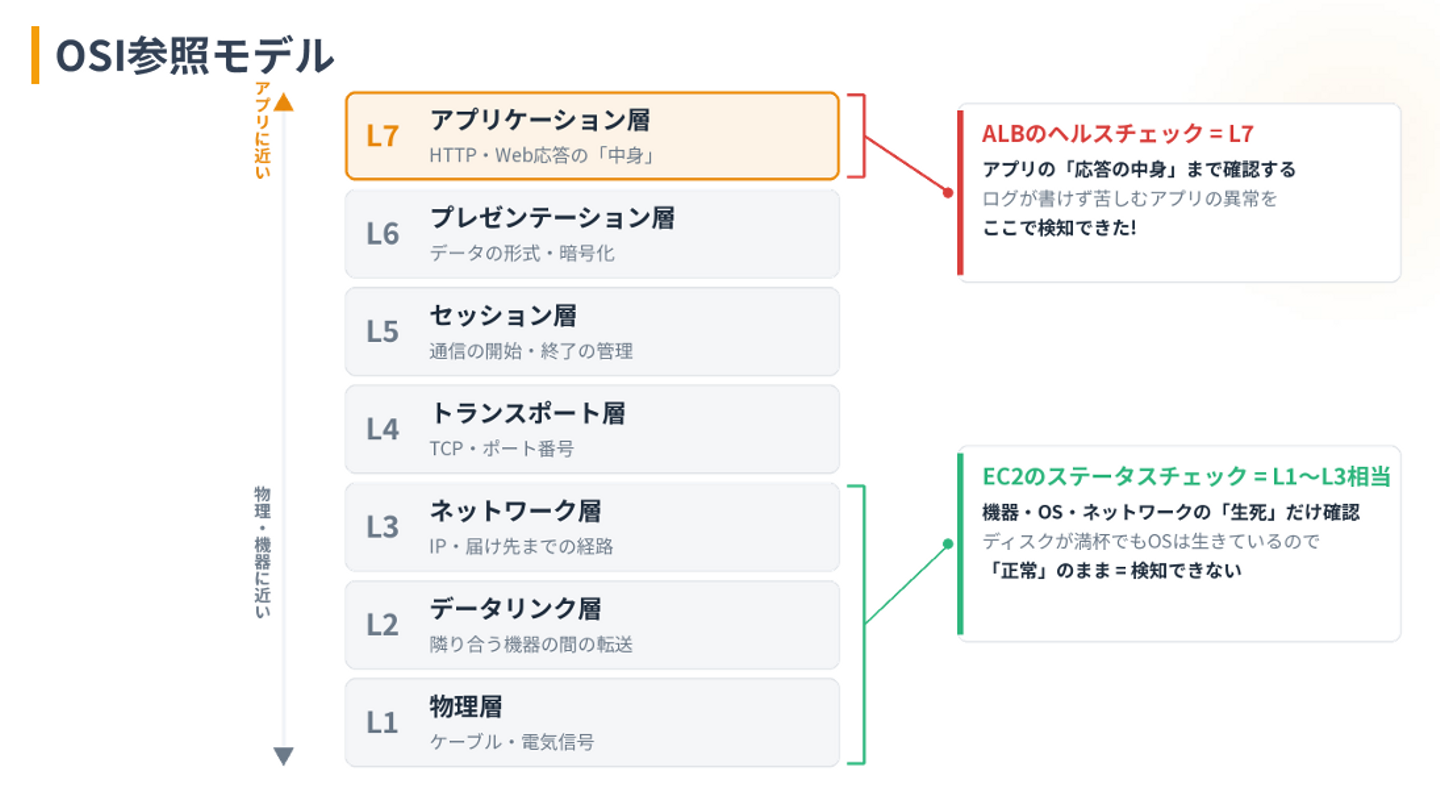
実はここに、インフラ監視の大きな落とし穴があります。 これを紐解くカギが、ネットワークの基本である『OSI参照モデル』です。
- EC2のステータスチェック(L1〜L3相当):
これは機器やOS、ネットワークの「生死(息をしているか)」だけを確認しています。ディスクが満杯でもOS自体は動いているため、「正常」と判定されてしまいます。
- ALBのヘルスチェック(L7相当)
こちらはWebアプリケーションの「応答の中身」まで確認します。ディスク満杯でログすら書けずに苦しんでいるアプリの異常を、ALBは見逃さずに検知できたわけです。
★どのレイヤを見ている監視なのかで、見えてくる異常が全く違います。 だからこそ監視は1つだけに頼らず、複数のレイヤに多層で仕込むことが鉄則なのです。
⚡ AWSだからできる「ラクする運用」の技術
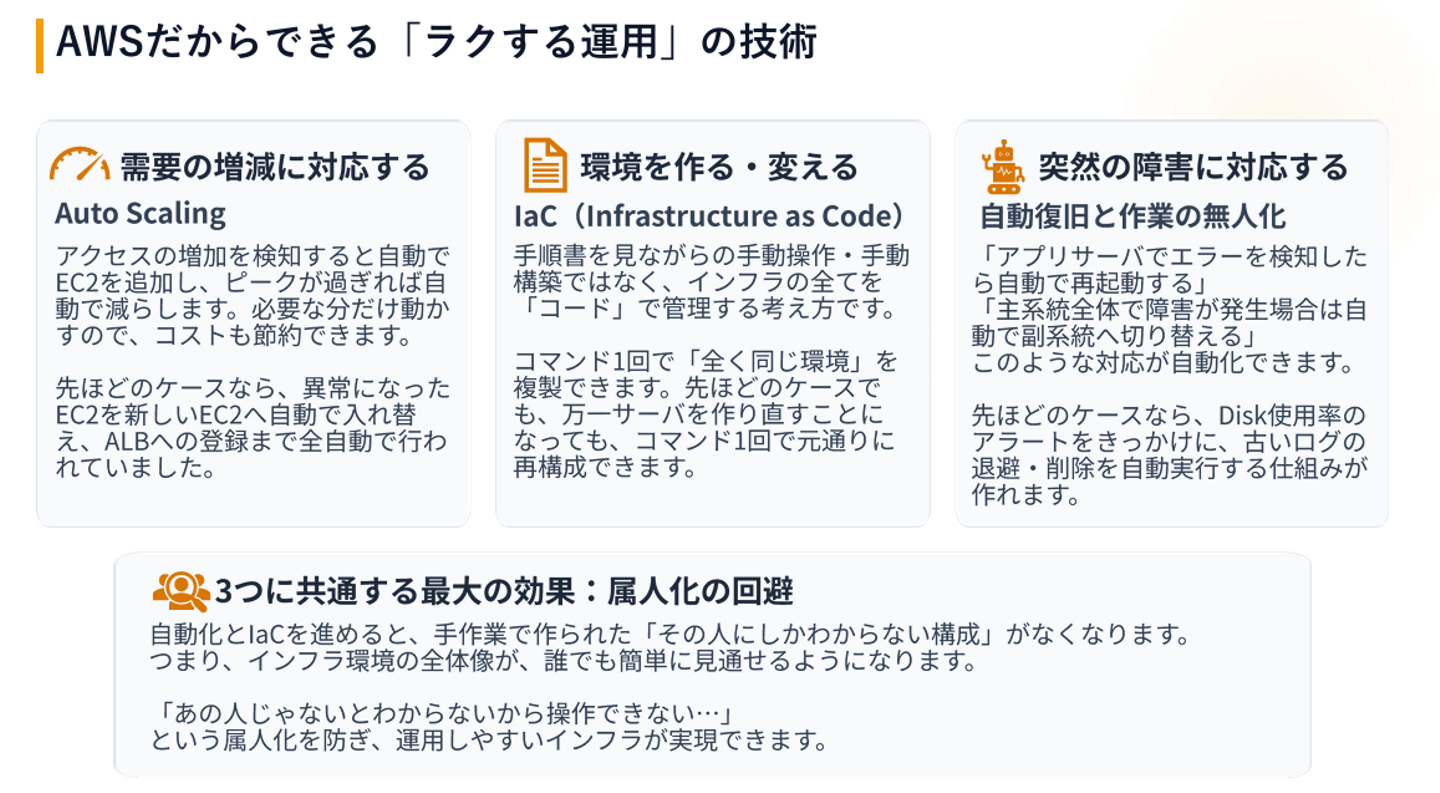
ここまでのトラブル対応を見て、「障害対応ってやっぱり大変そう…」と思った方。
ご安心ください。 クラウドの真骨頂は、『運用の自動化』にあります。
📈 需要の増減に対応する(Auto Scaling)
アクセス急増時に自動でサーバーを増やすだけでなく、先ほどのように異常になったEC2があれば、自動で新しい健全なEC2に入れ替えてALBに再登録する…なんてことも全自動でやってくれます。
📝 環境をコードで管理する(IaC)
手順書を見ながらの手動構築ではなく、インフラ全体をコード化(Infrastructure as Code)します。コマンド一発で「全く同じ健全な環境」を再構成できるため、万が一の作り直しも一瞬です。
🤖 自動復旧と作業の無人化
「ディスク使用率アラートを検知したら、Lambdaが起動して古いログを自動削除する」といった仕組みを作り込めば、人間が深夜に対応する必要すらなくなります。
これら3つに共通する最大のメリットは、【属人化の回避】です。 「あの人にしかわからない秘伝のタレ環境」をなくし、誰でも見通せるインフラを作ることで、チーム全体が安心して眠れる運用が実現できます。
👣 今日からできる!実践リスト
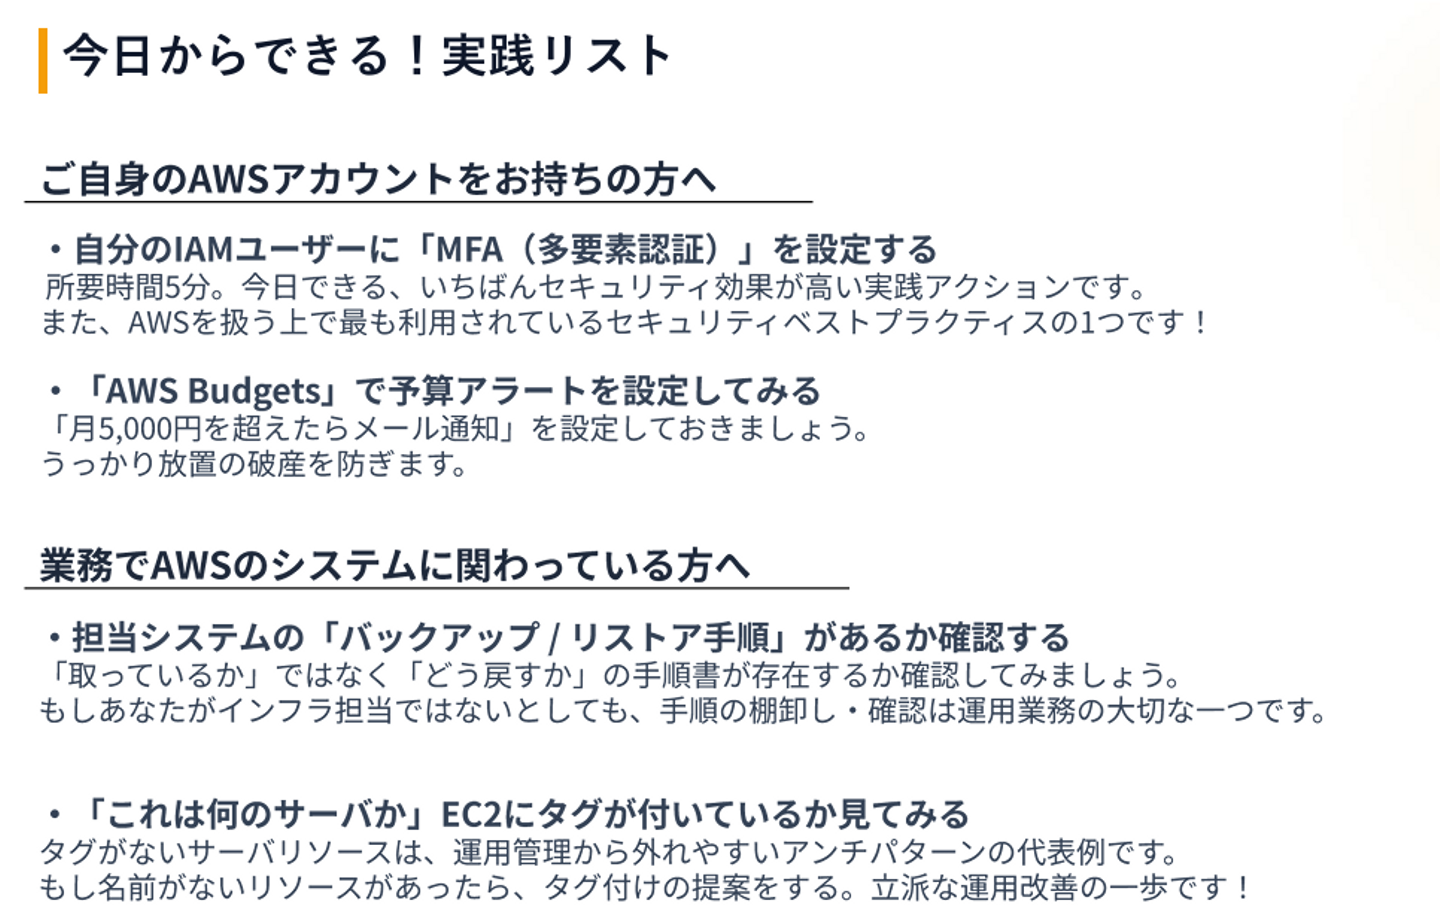
最後に、今回の勉強会を踏まえて「今日からすぐできるアクション」を板矢から皆さんにプレゼントです🎁
👤 ご自身のAWSアカウントをお持ちの方へ
- IAMユーザーに「MFA(多要素認証)」を設定する
所要時間5分。乗っ取りを防ぐ、最も費用対効果の高い最強のセキュリティ対策です。
- 「AWS Budgets」で予算アラートを設定する
「月5,000円を超えたらメール通知」を設定しておくだけで、うっかり放置による破産を防げます(イタヤの二の舞を防ぎましょう!笑)。
🏢 業務でAWSに関わっている方へ
- 担当システムの「バックアップ / リストア手順」があるか確認する
「取っているか」ではなく「どう戻すか」の手順書が存在するか確認してみてください。手順の棚卸しは、立派な運用改善の一歩です。
- EC2に「タグ」が付いているか見てみる
「これは何のサーバーか」がわからない野良リソースは事故の元です。もし名前がなければ、タグ付けを提案してみましょう!
いかがでしたでしょうか?
前編・後編の2回にわたってお届けした「AWS超入門・運用編」
皆さんの参考になっていれば幸いです✨
「言われたものを作るだけの環境を抜け出して技術を磨いていきたい」
「インフラや運用の知識をつけて、上流から提案できるPL/PMになりたい」
そんな思いをお持ちの方は、ぜひ会社ページをフォローして、今後の発信をお待ちいただけると嬉しいです!
その他にも、会社のカルチャーや福利厚生がよくわかるストーリーを多数公開中ですので、ぜひ覗いてみてくださいね🌈
最後までお読みいただき、本当にありがとうございました!
また次の記事でお会いしましょう(^O^)/

/assets/images/24080777/original/686d1498-c291-48a6-a612-a6a110062297?1782263834)