はじめに
「このシステム、仕様書どこにあるんですか?」
保守開発をしていると一度は口にする(あるいは言われる)セリフだと思います。引き継ぎ資料がない、設計書がない、コードだけが正義になっているプロジェクトは珍しくありません。新しく入ったメンバーがコードリーディングだけでキャッチアップするコストは馬鹿にならないですし、そもそも「今の実装がどういう意図で書かれたのか」はコードだけでは分からないことも多いです。
この課題に対して、「Claude Codeにソースコードを直接読ませて、仕様書を自動生成させる」というアプローチを試してみました。単に試すだけでなく、
- 自分でプロセスを設計してスキル化したもの
- すでに世の中に公開されている同種のスキル
を同じコードベースに対して独立に実行し、成果物を突き合わせるという比較実験をやってみたので、そのプロセスと結果を記録しておきます。
対象にしたのは、業務で扱っているNext.js + Prisma + PostgreSQL製の社内Webアプリ(+ Pythonの同期バッチが1本)です。以下では固有の名称は伏せ、単に「対象アプリ」と呼びます。
前提
モデルとアドバイザー(調査計画や成果物をレビューするAI。以下「レビューAI」)は以下で試してます。コード解析とドキュメント出力が主なので、まぁいいかなと。
- モデル
- Claude Sonnet 5
- アドバイザー
- Claude Opus 5
やったこと概要
- まず自分の手でリバースエンジニアリングをやってみる(Claude Codeを操作しながら、調査 → 検証 → 執筆)
- そのプロセスを再利用できるようClaude Codeのスキルとして型化する(spec-reverse-engineerと命名)
- 公平な比較をするために、世の中に公開されている似た目的のスキルを2つ調達する
- 3つのスキルを、互いの成果物を見せない状態で同じコードベースに対して実行する
- 成果物を突き合わせて比較評価する
- 比較で見えた改善点を反映した改良版スキルを作り、同じコードベースにもう一度実行して効果を確かめる
Step 1: まず自分の手でやってみる
いきなりスキルを設計するのではなく、最初に手動でリバースエンジニアリング作業をやってみることにしました。理由は単純で、「実際にやってみて分かる勘所」を先にスキルに反映したかったからです。
具体的には次のような流れで進めました。
- 対象コードベースの構造をざっと把握する(ディレクトリ構成、README、直近のコミット履歴)
- 規模に応じて、自分で直接ファイルを読むか、並列のAIエージェントに調査を分担させるかを判断する(今回は3つの領域に分けて並列調査した)
- 執筆に入る前に、レビューAIに「この調査計画・集めた事実で十分か」を相談する
- 既存のREADME・ドキュメントの記載を鵜呑みにせず、実際のコード・DBマイグレーション・CI設定ファイルで裏取りする検証フェーズを挟む
- ドキュメントを執筆する(アーキテクチャ設計書、データモデル仕様書、API仕様書、機能仕様書、そして既存ドキュメントとの相違点一覧)
- 書き終えたら再度レビューAIに相談し、指摘された未検証の主張を追加検証してから確定する
この過程で、対象アプリのREADME/CLAUDE.mdに書かれていた内容のうち、実装と食い違っている箇所がいくつも見つかりました。例えば「Slack通知の仕組みが存在する」という記載がありましたが、実際にはそのモジュールはすでに削除されており、通知は別の仕組み(監視基盤のログ検知)に一本化されていました。あるいは「認証を無効化する環境変数」の名前がドキュメントとコードで違っていた、などです。
こうした「ドキュメントと実装の相違点」を独立したファイルとして一覧化したところ、これが今回の作業の中で一番価値の高い成果物になりました。
Step 2: プロセスをスキル化する
手動でやってみた工程を、再現可能な形にスキルへ落とし込みました。ポイントだけ挙げると:
- 一次情報を正とする: README/コードコメント等は参考情報に留め、必ずコードそのもので裏取りする
- 事実と推測を明確に分離する: 断定できない内容には調査時点から推測ラベルを付け、最終稿でも安易に断定形へ書き換えない
- 規模に応じて調査手法を変える: 小規模なら自分で読む。並列エージェントはコンテキストを圧迫する規模のときだけ使う
- レビューAIに2回相談する: 執筆着手前と完成後
- 相違点一覧を付録に埋もれさせない: 独立したファイルにし、読者が最初に読むべきものとして先頭に置く
Step 3: 公平な比較のために、他のスキルを調達する
自分で作ったスキルを自分で評価しても説得力がないので、世の中に公開されている似た目的のスキルを探しました。
見つけて実際に使ったのは以下の2つです。
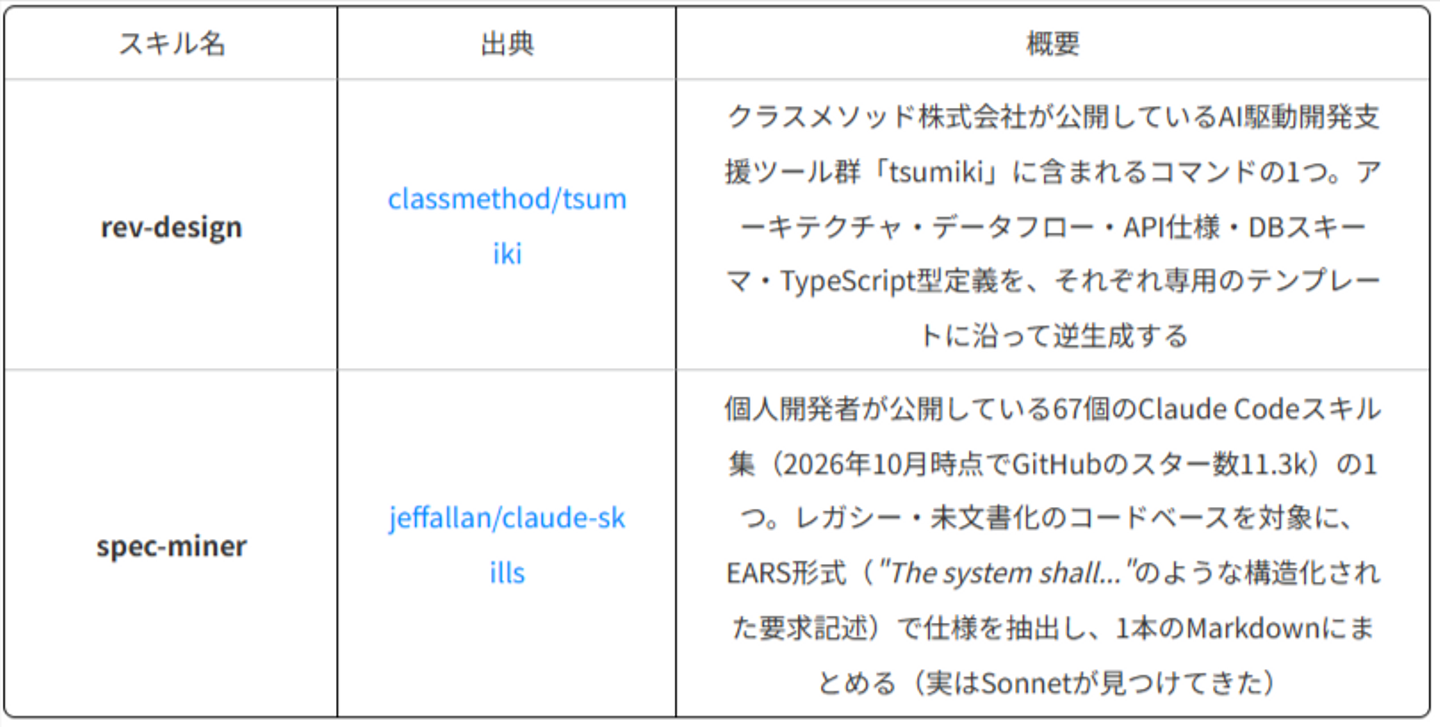
どちらも実際にGitHubからソース(SKILL.mdとその参照ファイル)を取得して、ローカルのスキルとして導入しました。
余談ですが、Sonnetが同様のスキルを探している途中で「バイナリ解析」「ゲームのリバースエンジニアリング」「Android/iOSアプリの解析」といった、かなり毛色の違う"reverse engineering"系スキルも大量にヒットしました、と鼻息荒く教えてくれました。
曰く「この単語、セキュリティ・ゲーム改造・Webアプリ設計書生成という3つの全く異なるコミュニティで同じ言葉として使われているのが面白かったです」とのこと。
こういうのが面白いみたいですね、Sonnet。この辺のセンスが理解できればもっとSonnetと仲良くなれそうですね。
余談まで。
Step 4: 独立性を担保しながら3つのスキルを実行する
同じセッション(=Sonnet)が3つのスキルを順番に実行すると、後から実行するスキルほど「もう答えを知っている状態」でコードを読んでしまい、比較として意味がなくなります。これを避けるため、rev-designとspec-minerはそれぞれ前提知識ゼロの独立したAIエージェントに実行させました。具体的には次のような指示を与えています。
- 対象コードベース以外は何も教えない
- 既に生成済みの他のスキルの成果物や、実験全体のメタ情報が書かれたファイルは絶対に読まない
- SKILL.mdの指示に忠実に従い、テンプレートのプレースホルダーは実際の調査結果で埋める(プレースホルダーのまま出力しない)
- 対象コードベースの実態がテンプレートの想定(例:JWT認証のREST API一覧)と食い違う場合は、テンプレートに引きずられず実態を優先する
この「独立性の担保」自体が、後述する比較結果の信頼性に直結する重要な設計判断だったと思います。
Step 5: 結果と評価
コスト比較
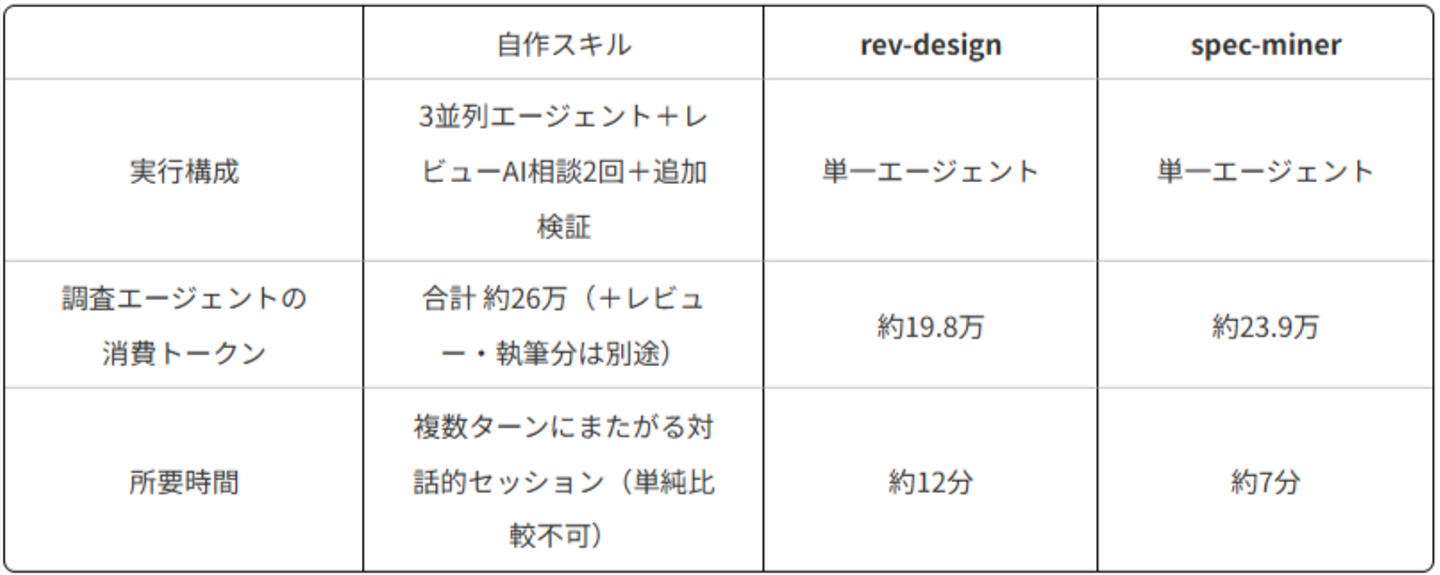
自作スキルは複数エージェント+レビューAIループという設計上、明確に最もコストが高くなっています。一方spec-minerは単一エージェント・単一ファイルの実行でありながら、後述の通り検証の厳密さでは引けを取らない結果を出していました。コスト対効果ではspec-minerが最も優れていた、というのが正直な感想です。
出力の違い
3つとも「このアプリは独自のREST APIをほとんど持たず、フレームワークの機能(Server Components / Server Actions)を直接データアクセス層として使っている」という、テンプレートの想定を裏切る核心的な実態を正しく見抜いていました。これは素直に驚きました。
差が出たのは「どこまで踏み込むか」でした。
- rev-design(テンプレート駆動)が強かった領域: 非機能要件を型として持っているため、アクセス解析ツールの有無、画像最適化の徹底度、APMツールの不在、CDN設定の不在など、「言われないと調べない」領域を漏れなく拾えていました。
- spec-miner(コード読解を制約として明示)が強かった領域: UIコンポーネント内部の業務ロジック(特定条件でボタンが非活性化する、エラーハンドリングの分岐条件など)まで踏み込んでいました。file:line形式の引用がほぼ全項目に付いており、根拠を辿りやすい構成でした。
- 自作スキルが相対的に弱かった点: 上記どちらの領域も「本書の範囲外」として明示的に除外していました。誠実ではあるものの、そもそも調査対象に含めていなかったので得られる情報もなかった、ということです。
3つが独立に見つけた「同じ指摘」
一番面白かったのがこれです。互いに参照させずに実行したにもかかわらず、3つのスキルが独立に同じ結論へたどり着いた指摘がいくつかありました。
- あるDBテーブルに、コードコメントだけでなく実際のDB制約(CHECK制約)としてビジネスルールが強制されていること
- 定義はされているが実際には読み書きされていない「死んだテーブル」が存在すること
- このアプリが独自のREST APIをほとんど持たない設計であること
3つの独立した調査が同じ結論に達しているというのは、その指摘の確度がかなり高いことを意味します。逆に言えば、AIに1回リバースエンジニアリングさせて出てきた結果を鵜呑みにするのではなく、複数の切り口で突き合わせることの価値を実感できました。
一方で、既存ドキュメントの記載ミス(環境変数名の食い違い)については、自作スキルとspec-minerは検出できましたが、rev-designは見逃していました。同じ情報源を見ていても、検出できる/できないの差が出ることも分かりました。
公開スキルに見つかった構造的な欠陥(?)
rev-designの成果物を読んでいて気づいたのですが、生成されたファイルの中に「(後述『気づいた点』参照)」という参照が2箇所あるのに、実際にはその「気づいた点」という見出しのセクションがどのファイルにも存在しませんでした。
実行したAIエージェントは、その内容を作業完了時の口頭報告(チャットの返答)には書いていたものの、成果物のファイルには反映していなかったのです。これはSKILL.md自体に「気づいた懸念をどこに書くか」という受け皿が設計されていないために起きた抜け漏れで、一度きりの偶然ではなく構造的なリスクだと思います。テンプレートの作り込みは非常に丁寧なスキルだっただけに、この点は意外でした。
総評
- 精度という一点ではスキル間に大きな差はありませんでした。核心的な発見は複数のスキルが独立に到達しています。
- 差が出たのはテンプレート・制約の設計でした。何を調べさせるかを型として強制すれば網羅性が上がり、コード読解そのものを制約にすれば深さが増す。トレードオフがはっきり見える結果でした。
- コストパフォーマンスでは、シンプルな単一エージェント構成のスキルが、重量級の自作スキルに引けを取らない検証水準を出せていました。これはちょっと悔しいですが、まぁ。。。
自作スキルへの示唆
比較結果を踏まえて、自作スキルの改善点も見えてきました。
…
記事の続きは下のURLをクリック!
https://rightcode.co.jp/blogs/56867
もっと上を目指したあなたへ
現在、ライトコードでは「WEBエンジニア」「データエンジニア」「ゲーム・XRエンジニア」「UI/UXデザイナー」「PM/PMO」などのポジションで積極採用中です!
ライトコードは、技術力に定評のある受託開発をメインにしているIT企業。
有名WEBサービスやアプリの受託開発などの企画、開発案件が目白押しの状況です!
- もっと大きなことに挑戦したい!
- エンジニアとしてもっと成長したい!
- モダンな技術に触れたい!
現状に満足していない方は、まずは一度、【Wantedly内の弊社ページ】をのぞいてみてください。