生成AIに社内文書やマニュアルなどの情報を参照させて回答させる「RAG」。
生成AIを実際の業務で活用するための技術として、さまざまなシステムで利用されています。
しかし、RAGを構築するには、文書を検索するためのデータベースなどが必要です。
そこで注目されているのが、AWSの「Amazon S3 Vectors」です。
低コストでベクトル検索を実現できるという特徴があり、RAGを構築する際の新たな選択肢になっています。
ただし、安いからという理由だけで採用すると、後から思わぬ制約に直面するかもしれません。
今回は、S3 Vectorsを使ったRAGを検討するうえで注意したい制約とコストについて、実際に検証してみました。
そもそもRAGには何が必要?
ChatGPTなどの生成AIは、さまざまな質問に答えてくれます。
しかし、社内独自の情報や最新の業務マニュアルなど、AIが知らない情報については正しく回答できないことがあります。
そこで利用されるのがRAGです。
例えば、「経費精算の申請期限を教えて」と質問されたとします。
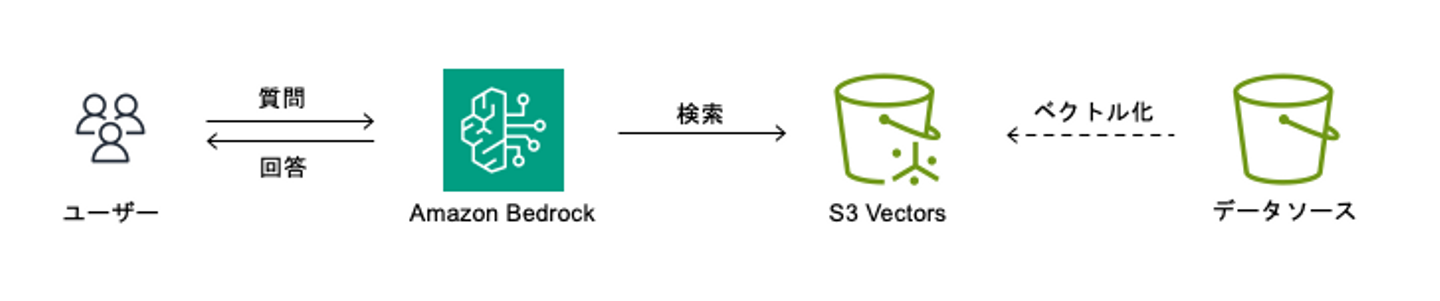
RAGでは、まず社内マニュアルから関連する情報を検索します。
そして、見つかった情報を生成AIに渡すことで、その内容をもとに回答できるようにします。
このとき、関連する情報を探すために使われるのが「ベクトル検索」です。
文章の意味を数値データに変換して保存し、質問と意味が近い情報を検索する仕組みです。
これまでは、AWSのOpenSearch Serverlessなどが保存・検索先として利用されてきました。
一方、S3 Vectorsはベクトルデータの保存と検索をシンプルに扱えるサービスです。
複雑な検索機能が必要なければ、RAGの検索基盤をより低コストで構築できる可能性があります。
低コストなら、S3 Vectorsを使えばよい?
ここで気になるのが「それなら、RAGは全部S3 Vectorsでよいのでは?」という点です。
実際には、そう単純ではありません。
例えば、社内文書を検索する場合、文章の内容だけでなく、
「どの部署の文書か」
「いつ更新されたか」
「誰が閲覧できる文書か」
といった情報も重要になります。
こうした文書に付随する情報を「メタデータ」と呼びます。
RAGでは、検索結果の表示や検索対象の絞り込みなどにメタデータを利用します。
しかし、S3 Vectorsには、このメタデータに上限があります。
Bedrockと組み合わせると、制限が変わる?
今回特に注意したいのが、Amazon Bedrock Knowledge Baseとの組み合わせです。
Bedrock Knowledge Baseは、AWS上でRAGを比較的簡単に構築できるサービスです。
その検索先としてS3 Vectorsを利用できます。
ただし、S3 Vectorsを単体で使う場合と、Bedrock Knowledge Baseから使う場合では、メタデータの制限が異なります。
具体的には、次のような違いがあります。
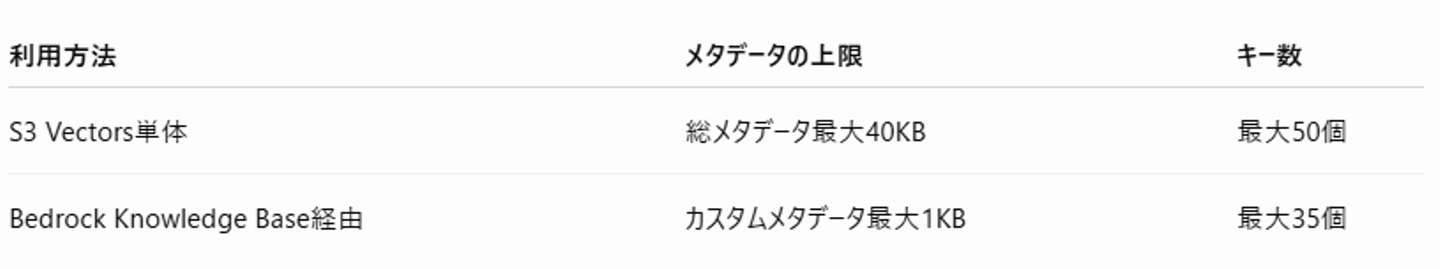
S3 Vectors単体では40KBまで保存できるメタデータも、Bedrock Knowledge Base経由ではカスタムメタデータが1KBに制限されます。
※S3 Vectors単体でも、検索条件に利用できるメタデータには別途2KBの上限があります。
実際の業務システムでは、ファイル名や作成日、部署、文書の種類、アクセス制御に必要な情報など、管理したい項目が増えていきます。
そのため、最初は問題なくても、後から機能を追加した際に制限へ達する可能性があります。
上限を超えるとどうなる? 実際に試してみた
では、制限を超えたメタデータを登録しようとすると、どうなるのでしょうか?
今回はBedrock Knowledge BaseとS3 Vectorsを組み合わせ、3つのパターンを検証しました。
① 正常なメタデータ
3項目、56バイトのメタデータを用意しました。
こちらは問題なく取り込まれました。
② 項目数が多すぎるメタデータ
36項目のメタデータを用意しました。
データサイズは434バイトと小さいものの、35項目の上限を超えています。
結果は、属性数の制限によるエラーでした。
③ データサイズが大きすぎるメタデータ
今度は項目数を1つにして、データサイズを1,262バイトにしました。
こちらは1KBの上限を超えたため、対象ファイルが取り込み時に無視されました。
つまり、制限を超えた情報が単に削られるのではなく、文書の取り込み自体に影響することが確認できました。
これはRAGにとって重要な問題です。
登録したつもりの文書が検索対象になっていなければ、AIはその文書を参照できません。
だからこそ、メタデータは「とりあえず全部保存する」のではなく、本当に必要な情報を考えて設計する必要があります。
もう一つの落とし穴は「検索料金」
S3 Vectorsを使ううえで、もう一つ注意したいのが料金です。
一般的に、検索サービスのコストを考えるとき、「月に何回検索するのか?」を気にすると思います。
もちろん検索回数は重要です。
しかし、S3 Vectorsではそれだけではありません。
検索対象となるインデックスのデータ量によっても、料金が変わります。
例えば、月に100万回検索するとします。
このとき、保存しているベクトルの数によって、検索料金は次のように変わります。
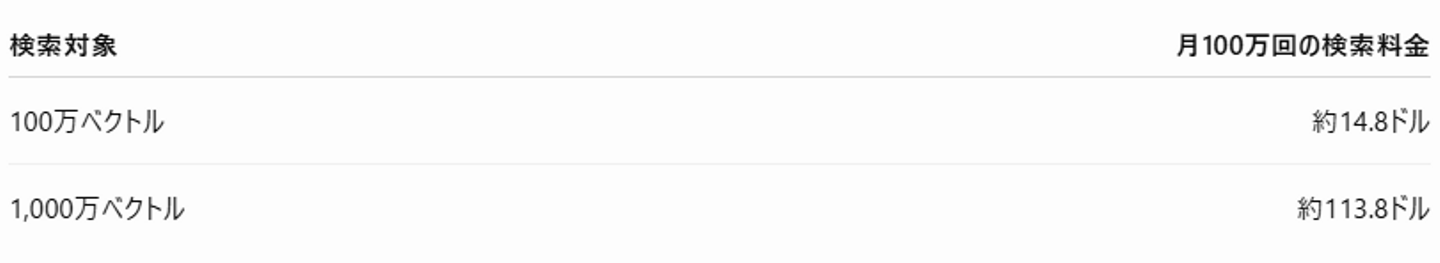
※2026年8月時点の東京リージョン料金をもとに、1ベクトル5KBとして試算したクエリ料金です。ストレージ料金などは含みません。
検索回数は同じなのに、料金には大きな差が出ています。
つまり、RAGの利用者が増えていなくても、登録する文書が増えることで検索コストが上がる可能性があるということです。
安く使うには、データの分け方も重要
では、どうすればよいのでしょうか?
例えば、営業部門と開発部門で、それぞれ異なる文書を検索するシステムを考えます。
すべての文書を一つの検索対象にまとめることもできます。
しかし、営業部門のユーザーが営業資料しか検索しないのであれば、開発部門の文書まで同じ検索対象に含める必要があるのか、考える余地があります。
そこで、業務領域などに応じて検索対象を分ける方法もあります。
検索対象を適切に分割することで、検索時に処理するデータ量を抑えられる可能性があります。
ただし、分割しすぎると管理が複雑になります。
そのため、単純に細かく分ければよいという話でもありません。
「どのような検索が行われるのか」「どれくらいデータが増えるのか」を考えて構成を決めることが重要です。
新しい技術は、実際に使えるかまで考える
今回S3 Vectorsを調べて分かったのは、低コストというメリットだけを見て技術を選ぶのは難しいということです。
S3 Vectorsは、シンプルなベクトル検索を低コストで実現したい場合に有力な選択肢です。
一方で、複雑な検索条件やテキスト検索などが必要なら、OpenSearch Serverlessのような別のサービスが適している場合もあります。
さらに、利用するサービスの組み合わせによって制約が変わることもあります。
「新しいサービスが便利そうだから使ってみる」だけでなく、「実際のシステムで使うと何が問題になるのか」まで確認する。
今回の検証では、そんなシステム設計の重要性を改めて感じました。
まとめ
今回は、Amazon S3 Vectorsを使ったRAGで注意したい制約とコストについて検証しました。
S3 Vectorsは、RAGを低コストで構築するための魅力的な選択肢です。
しかし、
- Bedrock Knowledge Baseとの組み合わせによって変わるメタデータ制限
- 上限超過による文書取り込みへの影響
- 検索対象のデータ量によって変化する料金
といった点には注意が必要です。
生成AIを使ったシステム開発では、AIモデルの性能だけでなく、周辺のデータ管理やクラウドサービスの構成も重要になります。
Acroquestでは、新しい生成AI技術を実際に試し、**「何ができるか」だけでなく、「業務で使うならどう設計するか」**まで考えながら検証を進めています。
最新のAI技術に触れながら、それを実際のシステムとして形にする仕事に興味がある方は、ぜひ一度お話ししましょう。
記事の詳細、検証に用いた実装コードなど詳しくは当社技術ブログに記載しておりますので、詳細を知りたい場合はこちらをご覧ください。
ぜひ、当社で一緒に働いてみませんか?
チャレンジングな案件が多く、成長の機会が多く得られる環境です
当社では、機械学習/AIや生成AIに加えて、AWSやAzureを活用したITサービス開発事業を推進しています。そこで、最先端技術を駆使しながら、社会を進化させたい情熱とスキルのある機械学習・AIエンジニア、クラウドエンジニアを募集しています!
私たちが取り組む案件は、最先端技術を用いる内容や高難易度の内容が多く、チャレンジングな環境なので、成長の機会が多く得られることをお約束します。


/assets/images/10338/original/b4c1f58c-4c92-447a-a0cc-671371e80f3a.png?1392712942)