社内でLTをやってみよう———
という声をきっかけに始まったのが、今回ご紹介するAI活用に関するLT大会です。
LTとはライトニングトークの略称で、5分程度の短時間で行う電光石火のプレゼンのこと。時間が短いため、話す側も聴く側も気軽に参加できることが特徴です。
当日はAIと協働するための考え方、Claude Codeスキル事例、言語モデルを5分で作る話から、人生の管理をClaudeに任せる話まで、社内LTのAI活用アイデアを紹介し合いました。
◼︎LTで初登壇することになった私
サーバーサイドチームの私(K)は、普段社内でメインスピーカーになる機会はなかなかありませんが、LTに初登壇することになります。
今回のLT大会はフロントエンドチームのUさん、Sさん、Mさんの3名が主催で、他に登壇者を募集しているところでした。3名ともとても優秀な方ですので、いやいや自分がこのメンツに混ざって技術的なテーマで登壇なんて、と少々気後れしていました。
私はいまだに喫茶店に1人で入る時に、一回店の前を通り過ぎて立ち止まってから、よし。と準備をしてから入るような小さい心臓の持ち主なのですが、そんなハートを「気楽に参加して欲しい!むしろ登壇してくれると助かる!」とお三方がもみほぐしてくれました。
ここまでハードルを下げてくれたならいい機会だと思い、話すテーマもまだ何も考えていないけど「なんとかなれっ!」と、先に登壇することだけ決めてしまいました。
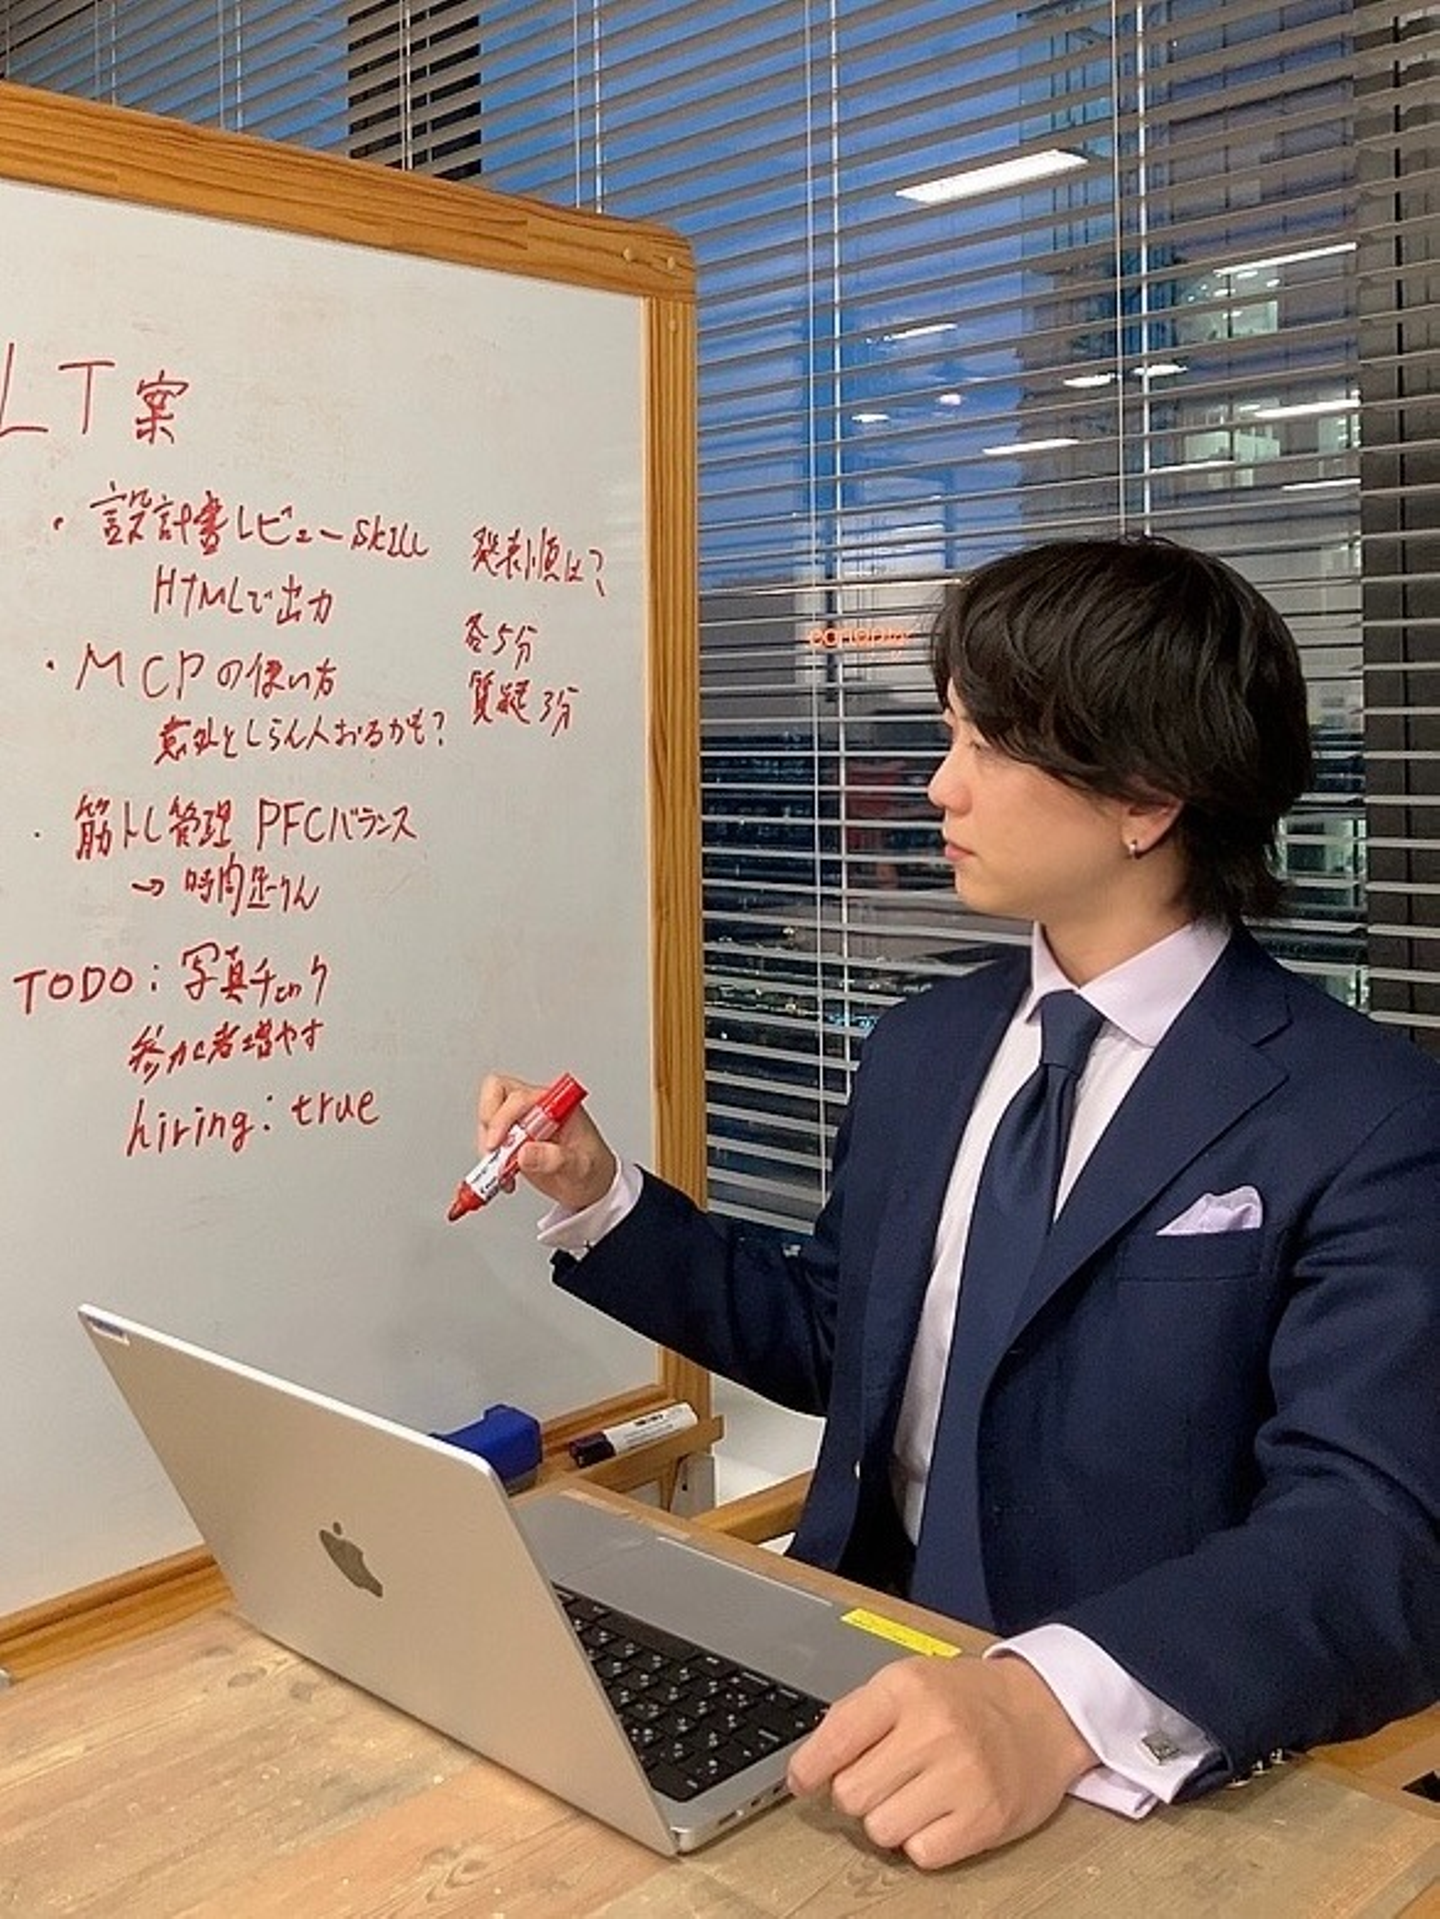
LT準備中。2週間の準備期間を経て、LT当日を迎えます。
◼︎ライトニングトーク当日
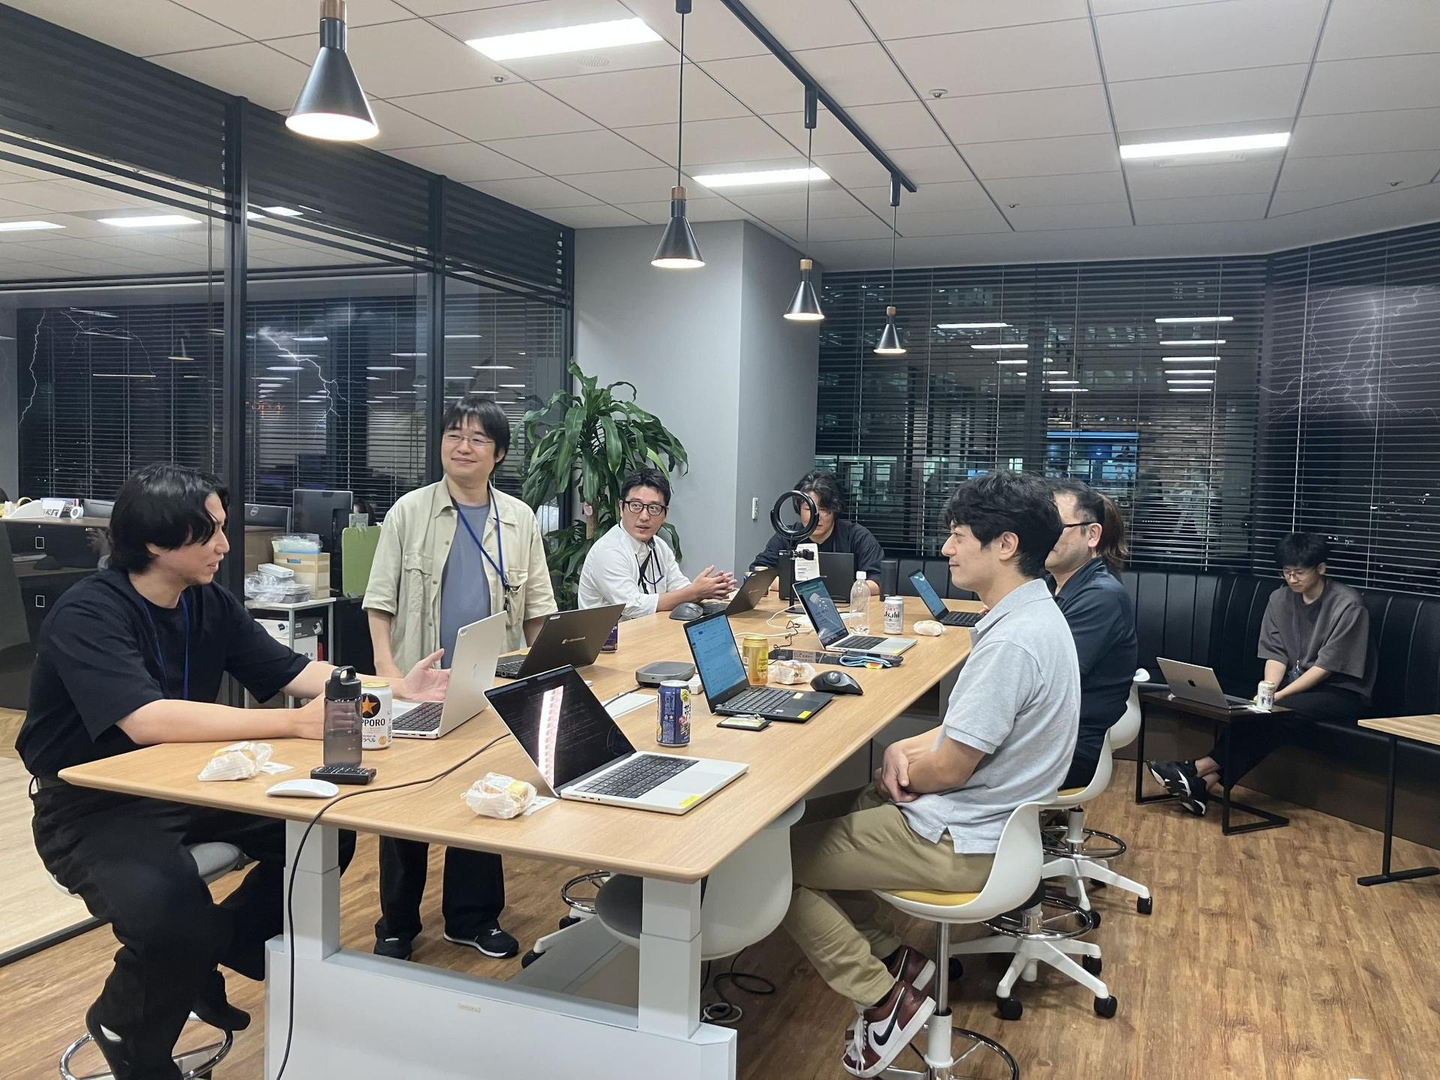
業務終了後の開催でしたが、オンラインを含め、多くのメンバーが積極的に参加してくれました!
Uさん「AI Fluencyについて」
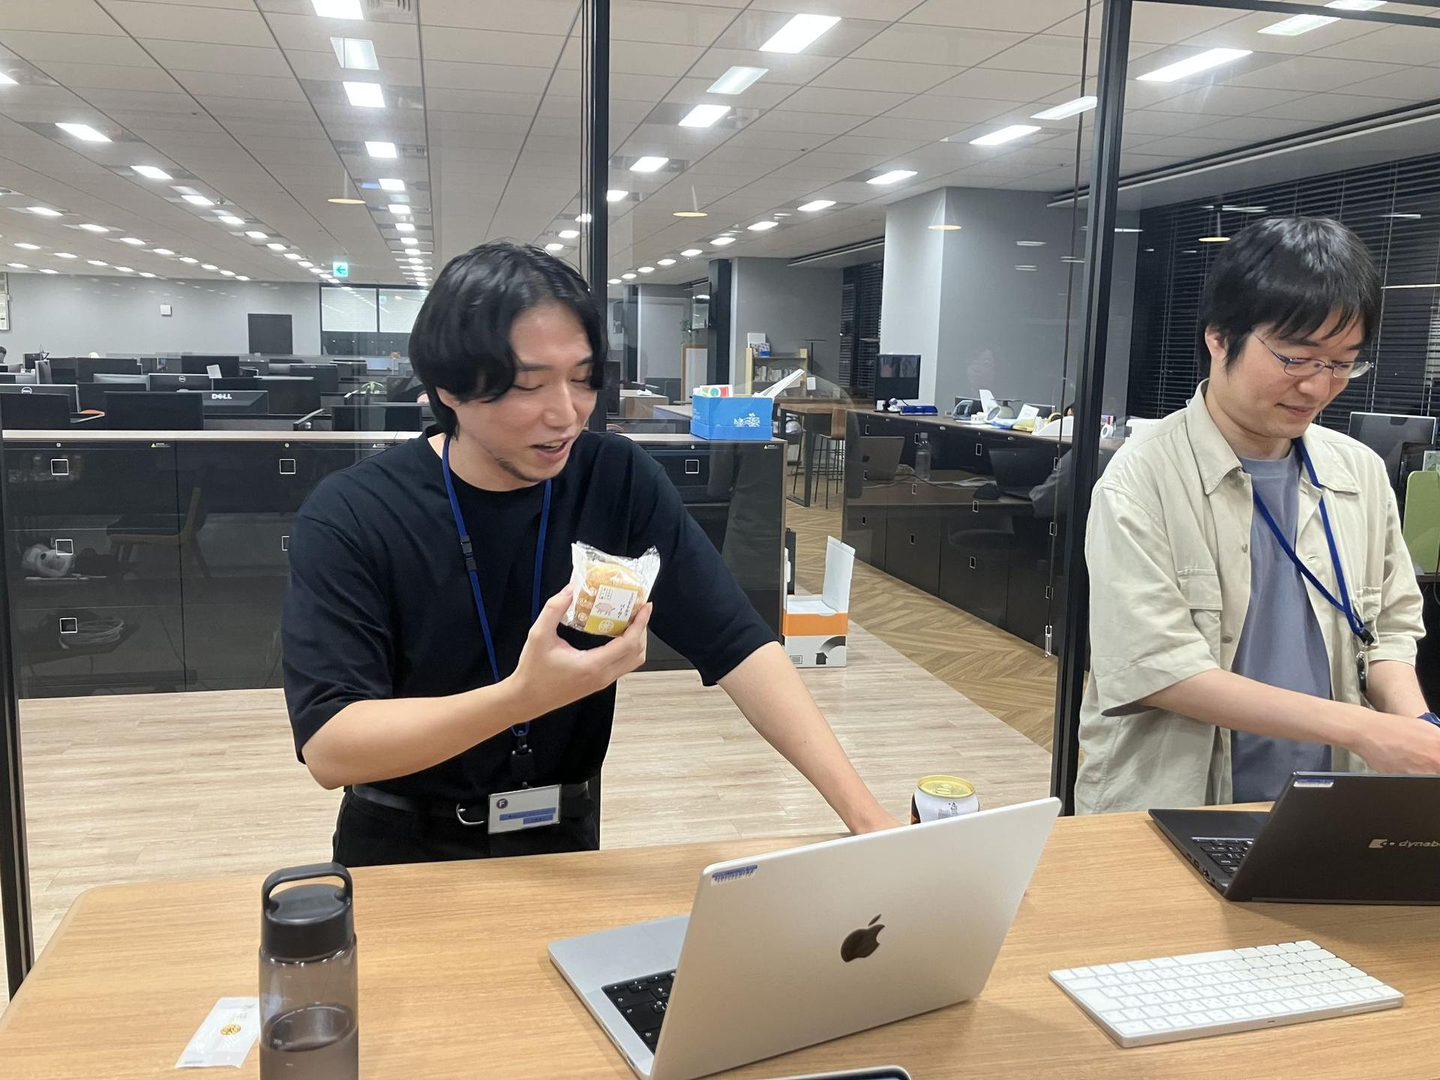
トップバッターのUさんには、AIと協働するための能力「AI Fluency」の概要をご説明いただきました。
AI Fluencyとは、
- 何をAIに任せるか(Delegation)
- どう意図を伝えるか(Description)
- AIの出力をどう評価するか(Discernment)
- どう安全・倫理的に利用するか(Diligence)
という4つの要素(4D Framework)で定義されます。
Uさんのお話で強調されていたのが、「Delegation(任せる)」と「Discernment(評価する)」をセットで設計することでより効果的にAIを使うことができるという話です。
AIに大量の仕事を任せるほど、人間が内容を見て、修正して、と負担も増えます。全ての出力を人がチェックしていては、結局「人間の確認待ち」が最大のボトルネックになりAI導入のメリットが薄くなってしまいます。
そこで大事になるのが、全てを愚直に検証するのではなく、必要なポイントだけをAIに抽出させたり、判定ルールを明確にするなど、評価の設計をすることです。
「何をAIに任せるか」だけでなく、「人間がいかにAIを効率的に正しく評価するか」という設計がAI Fluencyを高める原則であるとお話しいただきました。
私もつい、あれとこれも自動化できたらおもろそうやん!と何でも任せたくなりますが、もし他メンバーから「これどうやって判断してんの?」と聞かれた時に、私にしか評価できない使い方をしていては意味がないわけです。私だけが評価できる使い方=ただの属人化作業となり、チームとしてAI Fluencyが高まっているとは言えないでしょう。
まずは自分が使いこなすところから、次にチームとして再現性のある仕組みまで考えられると素敵ですね。
私(K)「Claudeの設計書レビューSKILL紹介」
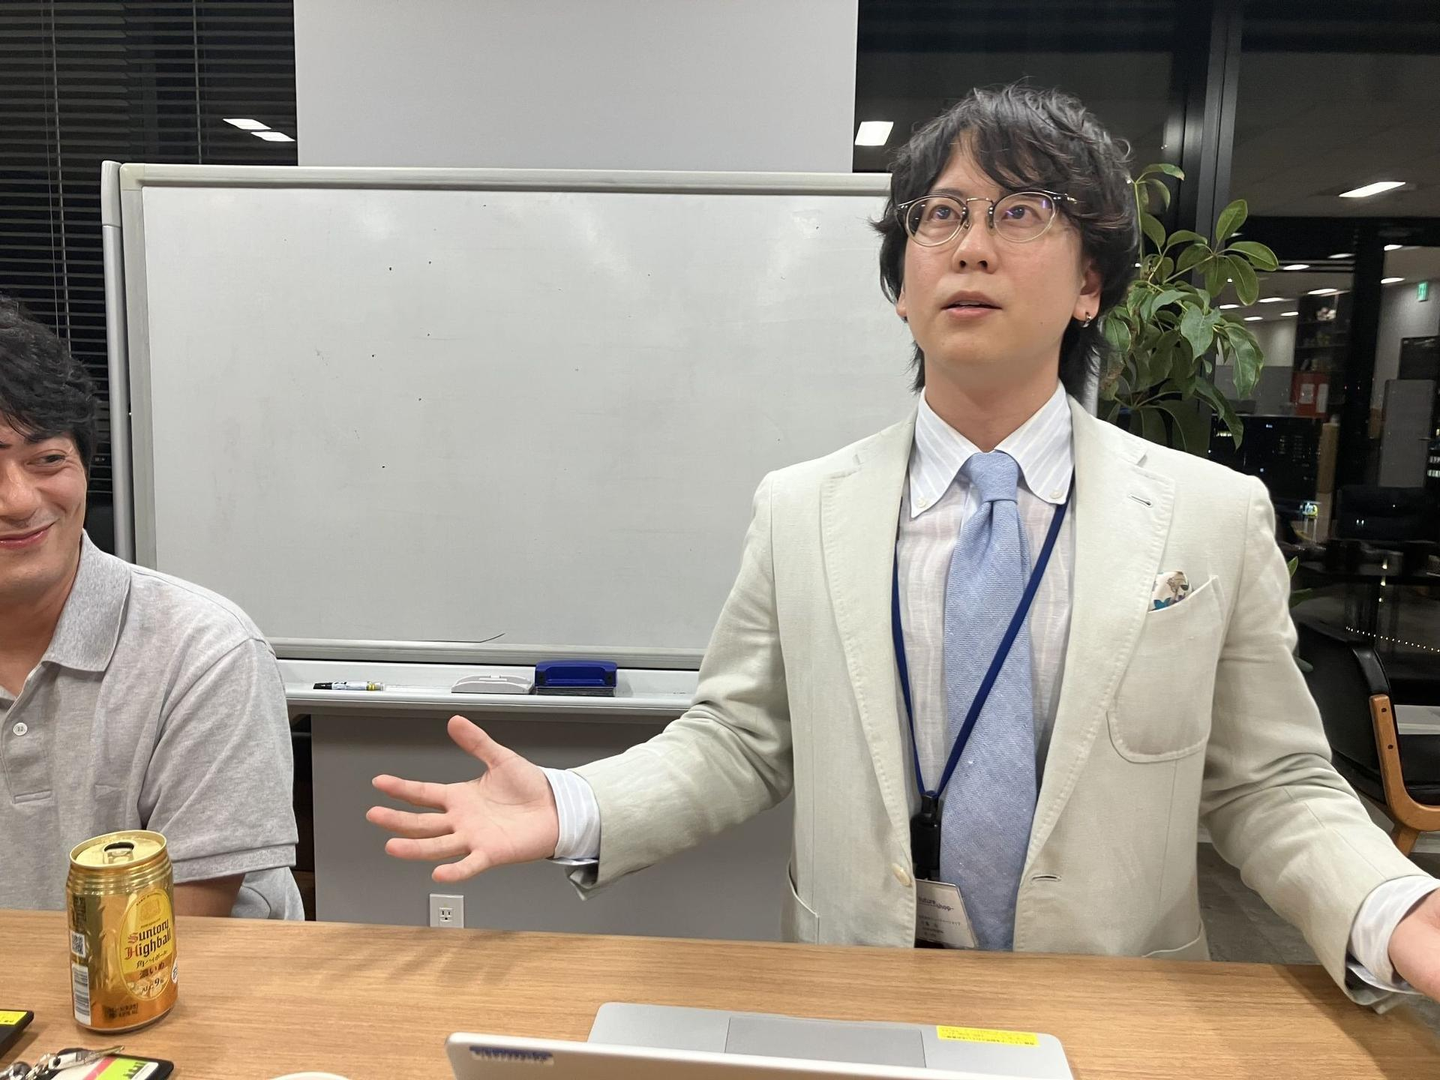
コードの生成やコードレビューは多くの方が既にやっていますが、設計書のレビューは他チームのPJではどうしているのだろう?と思ったので、私のチームのやり方がどなたかの参考になればいいな、という紹介をしました。
旧来のやり方では、レビューのたびに「マニュアルのURLはこれ」「要件資料はこのファイル」と貼り付けてプロンプト入力をしていました。資料の数は何十個とあるので、これが毎回発生します。
大変かったるいので、どの機能のレビューに、どの資料が必要かをJSONに書き出してINDEX的なファイルとして使います。
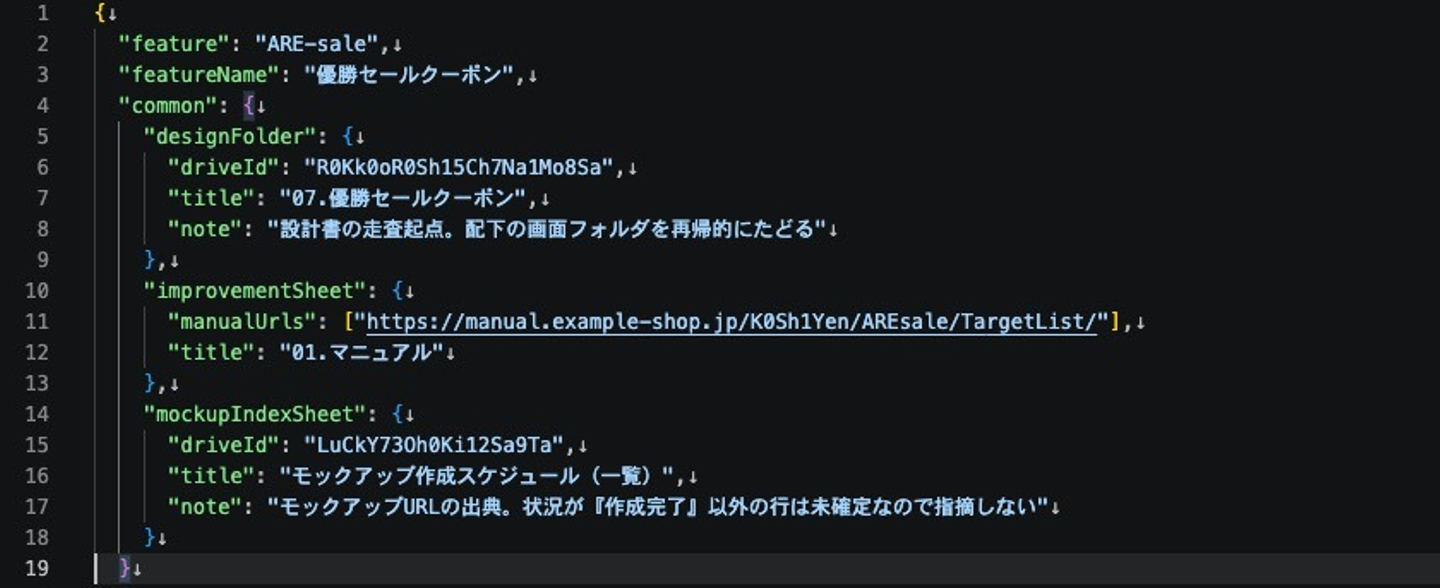
一度書いておけば、次からはレビュースキルに画面名を伝えるだけ。スキルがこのJSONを読み、MCP経由で設計書・モックアップ・マニュアルを自分で集めてきます。人間が毎回やっていた「資料集め」の工程がまるっと消えました。
また、AIのレビュー指摘内容をMarkdownではなくHTMLで出力することで、人間にとってより見やすい出力形式を採用していることも併せてご紹介しました。先ほどのUさんのお話にあった 評価しやすいDiscernment にも関係する内容かもしれません。
目新しい話や難しい話は一切しませんでしたが、思っていたより好反応をもらえて、地味に役立っているようで何よりでした。
Sさん「5分で作る言語モデル」
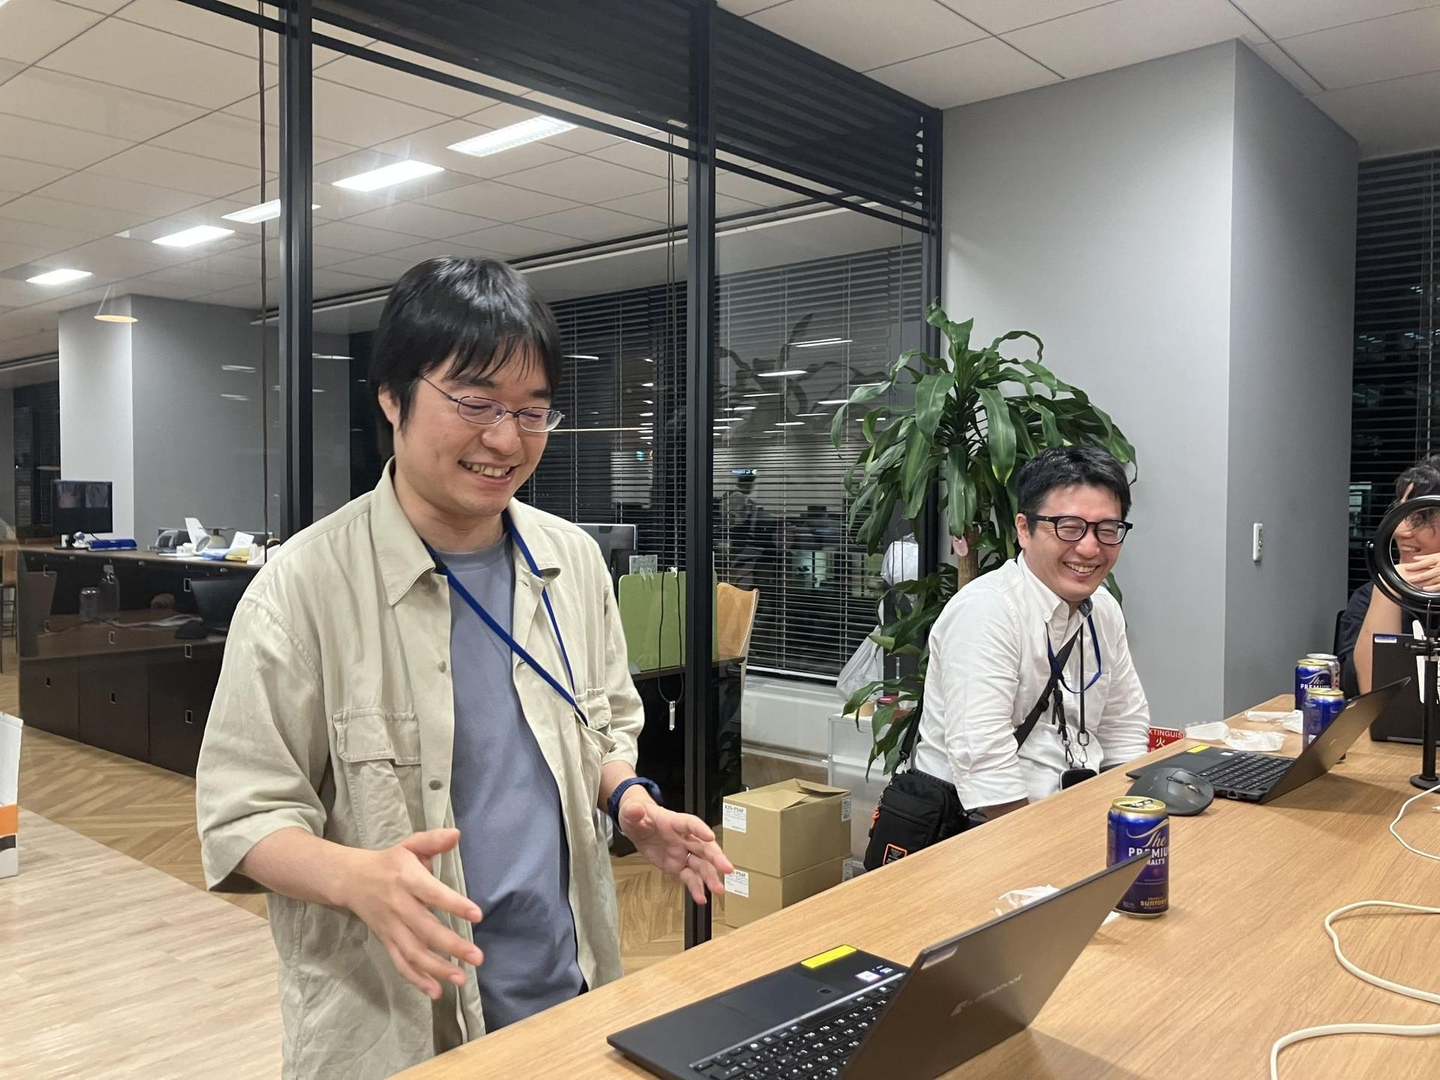
Sさんには、「5分で作る言語モデル」と称して、ご自身で作った言語モデルの実演をしていただきました。
Sさん曰く、言語モデルとは「これまでの文章から、次にくる言葉を予測するだけの関数」とのこと。
ただの関数なのだから、5分あれば自分でも作れちゃいます。と、Sさんはごく小さな語彙と短いコードだけでミニ言語モデルを組み立て、実際に文章を生成させてみせてくれました。
ここで気になるのが、「じゃあChatGPTとかClaudeって、こんな風に作られているんですか?」というところですが、これは「全然違います」と、きっぱり否定。
ChatGPTやGemini、Claudeのような大規模言語モデル(LLM)は、膨大な語彙とパラメータを大量のデータから学習して作られていて、まったく別物なのだと教えてくれました。
とはいえ、「文脈から次の言葉を予測する関数である」という型そのものは、5分で作ったミニモデルもLLMも同じ。
難しそうに見える技術も分解してみると意外とシンプル、ということはエンジニアをやっていると様々な分野で経験しますが、こういった学びは大切ですね。
Mさん 「人生を1つのリポジトリで運用している話」
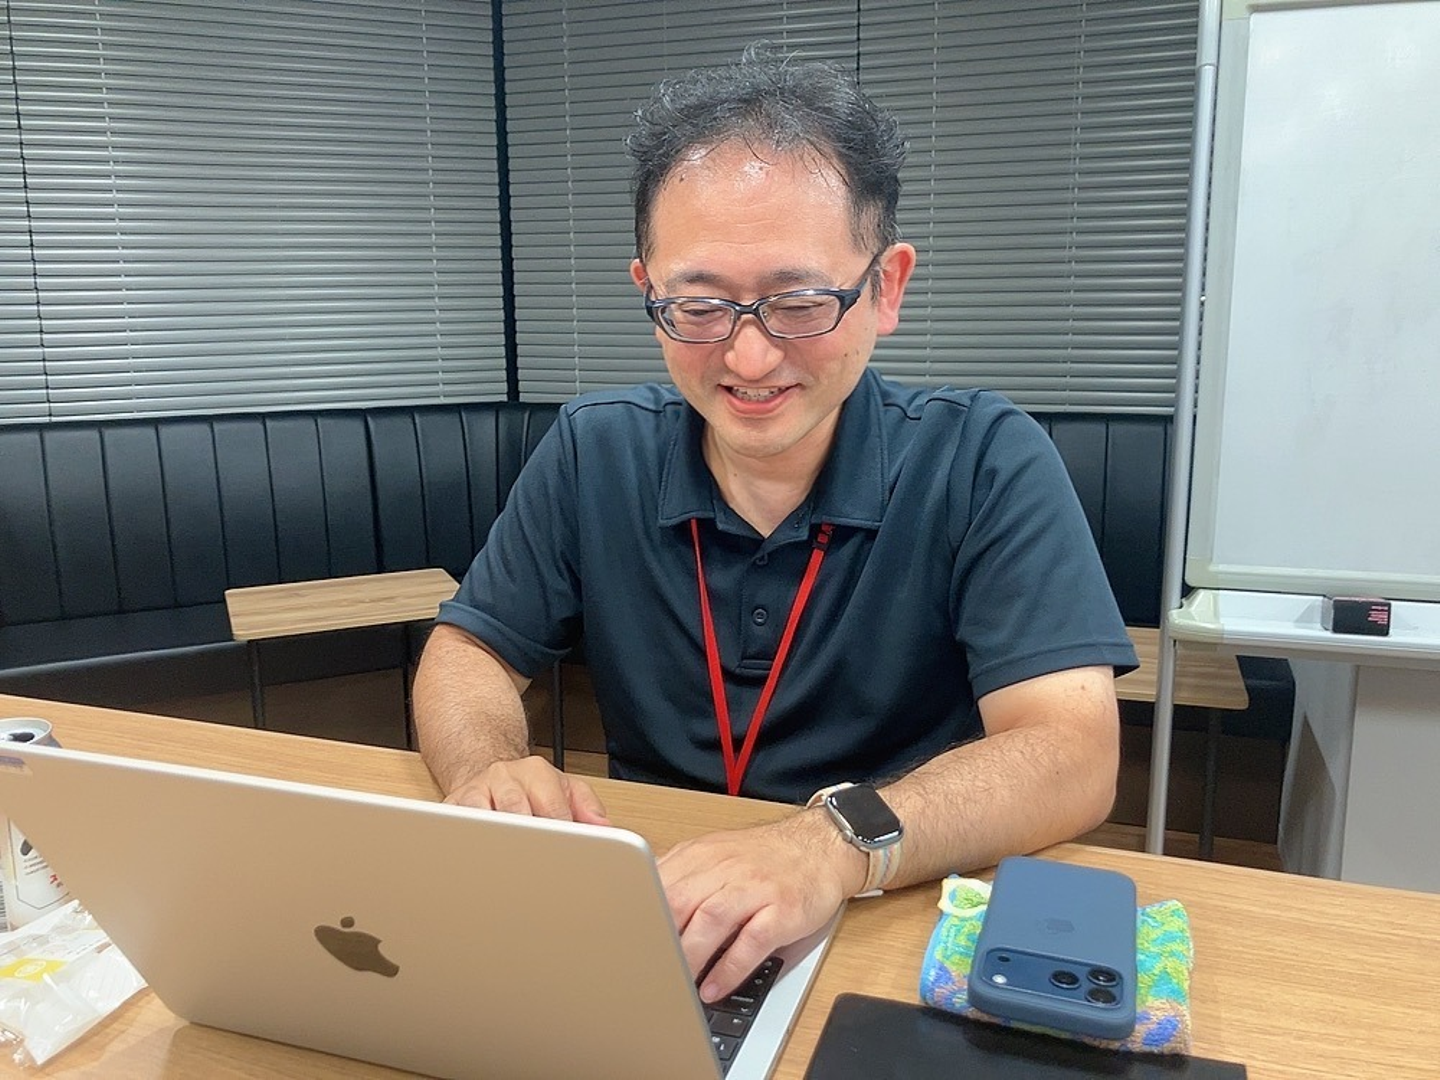
技術を仕事だけではなく自分の生活そのものに使ってみた、というおもしろいテーマでした。
読書管理、カンファレンス参加記録、健康相談、日々のトレンド収集など、生活のあらゆる領域をプレーンテキスト(Markdown)で記録し、GitHubで履歴を管理。それぞれの記録作業はClaudeのスキルで行っているとのことです。
今年の2月に運用を始め、約半年で作ったスキルは10本、積み上げたコミット数は363回、Markdownファイルは392本にのぼります。
専用アプリやDBも使わないシンプルな仕組みですが、
・特定のアプリに依存しないからサービス終了などで記録が消える心配がない
・Git管理のため「いつ、何を変えたか」が残る
・生成したMarkdownはそのままAIに読み込ませて相談やスキルの修正ができる
というメリットもよく考えられています。
これはちょっと真似してみたい…と思った方もいらっしゃるかもしれませんが、「CLAUDE.mdに自分の興味領域を書いて、スキルを1本作ってみる」だけで始められるため、エンジニアでない方にも真似できそうなのが面白いポイントです。
もし私が真似するなら筋トレ記録を管理をするだろうか…。
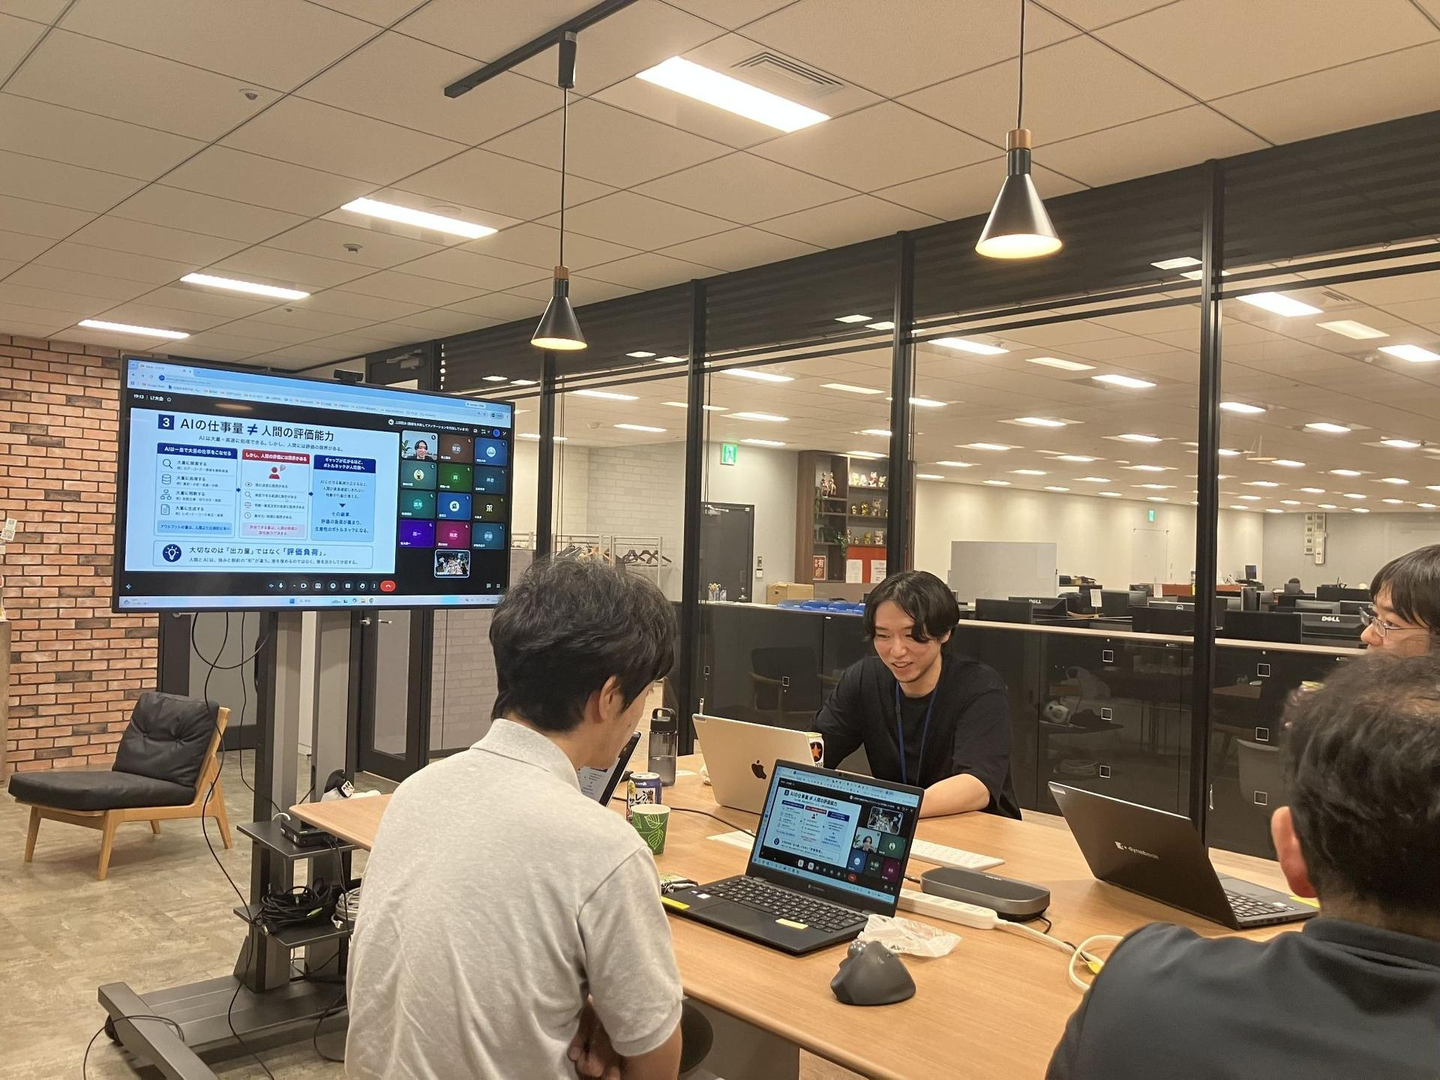
オンライン参加のメンバーもたくさんいらっしゃいました。
◼︎発表を振り返って
あえて不慣れな発表の場に飛び込んで、自分が1番未熟であると感じる経験をしよう!という気持ちで参加したLTでしたが、試されるような空気は全くありませんでした。むしろ話す側も聞く側もリラックスして楽しんでいたように思います。カジュアルな雰囲気の中にも、レベルの高い知見が飛び交うのがLTの面白いところでした。
そして何より、こうやってアウトプットする人が一人また一人と増えていくことで、社内はどんどん面白い場になっていくのだろうと思います。
今回オーディエンスとして参加された方や、LTに参加したことがない方の中にも、『自分も登壇してみようかな』と思っていただけたら嬉しいですね!