はじめに
前回、新田さんからBigQueryに関して色々と教わったので、
今回は公開データセットであるGoogle Trends(Googleトレンド)を活用し、
コスト(スキャン量)を最小限に抑えながら
「東京都の5日分のトレンドTOP5」を抽出するまでの検証を行いました。
その過程で見られたパーティションの挙動と、データの癖についてまとめます。
前回の記事はこちら↓
1. 検証の背景と試行錯誤
なにか公開されているデータで面白いのは無いかな、といろいろと調べてみたところ、
日本の都道府県別検索ランキングが取得できるBigQuery公開データセット bigquery-public-data.google_trends.international_top_terms というのがあったのでこの辺の中身を見てみました。
データ自体はいろいろと取れそうでしたが、そのまま取ろうとすると1クエリあたり数十GBとなってしまうので、
まずは単なるデータ取得にとどまらず、パーティションを意識してコスト出来るだけ抑えながら取得することを目指しました。
2. コスト最適化
BigQueryはクエリ実行時にスキャンしたデータ量に応じて課金されるので、
全体スキャンが発生する状態と、日付で仕切られたパーティション・検索キーによるクラスタリングを設定した自作テーブルへのアプローチを比較した結果、驚異的な差が出ました。
設定前(フルスキャン): 15.33 GB
設定後(パーティション+クラスタリング): 5.68 MB
上記は一例ですが、明らかに数値が変わりました。
本棚全体を探す(フルスキャン)のではなく、「特定の年・月の箱(パーティション)」を開き、さらに「あいうえお順に並んだ仕切り(クラスタリング)」から必要なデータだけをつまみ食いすることで、スキャン量を激減させることが実証できました。
3. 47都道府県別 TOP5 の抽出
続いて、47都道府県別のTOP5を取得するSQLを構築しました。
SELECT

  region_name AS prefecture, -- 都道府県名

  rank,                      -- 順位(1〜5位)

  term,                      -- 検索キーワード

  score,                     -- スコア

  week,                      -- 対象の週

  refresh_date               -- データの更新日(パーティション)

FROM

  `bigquery-public-data.google_trends.international_top_terms`

WHERE

  refresh_date = '2026-07-08'

  AND country_name = 'Japan'

  AND week = '2026-07-05'

  AND region_name IS NOT NULL

  AND rank <= 5

  AND score IS NOT NULL

ORDER BY

  region_name ASC,

  rank ASC;
【分析結果から見えた面白トピック】
全体傾向: 全国的にサッカー関連(三笘薫 事故、佐野 海舟 リバプール、移籍)や著名人・政治(渡辺えり、高市早苗)が市場を占有。
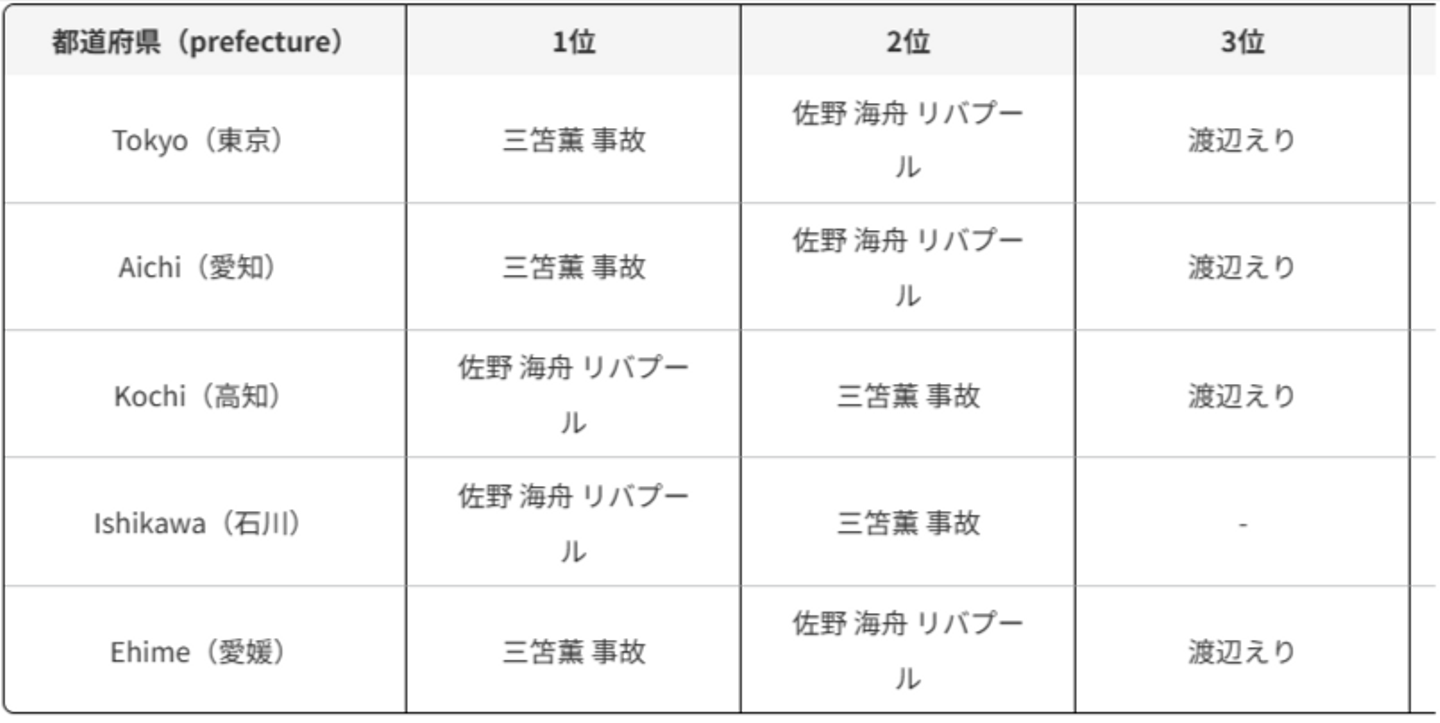
地域ごとの関心差: 一部順位が異なれど、日本全国を都道府県別にしてもほぼ一緒でした。
ただ、順位の歯抜け(欠番): 福井県や島根県など一部の地域で「3位が存在しない(1, 2, 4, 5位になる)」現象が発生してました。
これは同率スコアによる順位スキップや、一定の検索ボリューム(しきい値)に満たないデータが除外されるGoogleトレンド特有の仕様によるものと判明しました。
こういった感じだと正確な調査は難しいなと。
4. 東京都の「直近5週間×TOP5」の取得とハマりポイント
次に、東京都(Tokyo)にフォーカスし、7月8日時点から過去5週間分(6/7〜7/5の各週)のTOP5(計25件)の時系列変化を抽出する検証を行いました。
ここで大きく2つのハマりポイントと解決策がありました。
① スキャン量が 2.8 GB に跳ね上がる問題
当初、過去5週間分のデータを取得しようと、更新日(refresh_date)側を5週間分(あるいは複数日分)の範囲指定で取得しようとしました。
しかし、refresh_date の範囲を広げると、1日あたり約400MBのパーティションを複数日分読み込んでしまい、スキャン量が 2.8 GB まで跳ね上がってしまいました。
【解決策】
international_top_terms テーブルの構造を調べたところ、最新の更新日(refresh_date = '2026-07-08')のパーティション1箱の中にも、過去数週間分(week)の履歴データが一緒に含まれていることがわかりました。
したがって、refresh_date は最新の1日分に固定したまま、内部に含まれる week だけをサブクエリで5週分指定することで、スキャン量を 約400MB(1/7以下) に抑え込むことができました。
② 件数が25件にならず16件しか取れない問題
rank <= 5 を指定しているにもかかわらず、過去の週で1〜3位が消失し、16件しか取得できませんでした。
「過去データの欠損か?」と疑い、WHERE week = '2026-06-07' で全順位を出力する検証SQLを実行したところ、
JSON

{

  "rank": "1",

  "term": "三笘薫 事故",

  "score": null  <-- ココ!

}
【原因判明】
1〜3位のレコード自体は存在していたものの、過去の週のデータであるため score が null になっていました。
クエリに書いていた AND score IS NOT NULL が原因で、1〜3位が自ら弾かれていたことが判明しました。
5. 完成したSQL
AND score IS NOT NULL を除外することで、スキャン量を約400MBに抑えたまま、目標であった「5週×5件=計25件」の完全取得に成功しました。
WITH latest_5_weeks AS (

  SELECT DISTINCT week

  FROM `bigquery-public-data.google_trends.international_top_terms`

  WHERE refresh_date = '2026-07-08'

    AND country_name = 'Japan'

    AND region_name = 'Tokyo'

    AND week <= '2026-07-08'

  ORDER BY week DESC

  LIMIT 5

)

SELECT

  t.week,           -- 対象の週(日付)

  t.rank,           -- 順位(1〜5位)

  t.term,           -- 検索キーワード

  t.score,          -- スコア(null含む)

  t.region_name,    -- 地域名(Tokyo)

  t.refresh_date    -- パーティション日(2026-07-08)

FROM

  `bigquery-public-data.google_trends.international_top_terms` AS t

INNER JOIN

  latest_5_weeks AS w ON t.week = w.week

WHERE

  t.refresh_date = '2026-07-08'

  AND t.country_name = 'Japan'

  AND t.region_name = 'Tokyo'

  AND t.rank <= 5

ORDER BY

  t.week ASC,       -- 週を古い順(過去 ➔ 直近)

  t.rank ASC;       -- 1位 ➔ 5位
【最終?結果と考察】
超ロングヒットの可視化: 東京都においては、直近5週間(6/7〜7/5)にわたってTOP5の顔ぶれ(1位: 三笘薫 事故、2位: 佐野 海舟 リバプール、3位: 渡辺えり、4位: 高市早苗、5位: 移籍)が全く同じメンバーで固定化されていることがわかりました。
ただ、取得の仕方の問題で、本当の週間の情報はどうだったかもっと調べてみる必要はありそうです。
…
記事の続きは下のURLをクリック!
https://rightcode.co.jp/blogs/56595
もっと上を目指したあなたへ
現在、ライトコードでは「WEBエンジニア」「データエンジニア」「ゲーム・XRエンジニア」「UI/UXデザイナー」「PM/PMO」などのポジションで積極採用中です!
ライトコードは、技術力に定評のある受託開発をメインにしているIT企業。
有名WEBサービスやアプリの受託開発などの企画、開発案件が目白押しの状況です!
- もっと大きなことに挑戦したい!
- エンジニアとしてもっと成長したい!
- モダンな技術に触れたい!
現状に満足していない方は、まずは一度、【Wantedly内の弊社ページ】をのぞいてみてください。