こんにちは。ウォンテッドリーのEnablingチームでバックエンドエンジニアをしている小室(@nekorush14)です。Enablingチームでは技術的な取り組みを社外にも発信すべく、メンバーが週替わりで技術ブログをリレー形式で執筆しています。前回は冨永さんによる「生成AIを用いて履歴書からプロフィールを自動生成する試みについて」 でした。今回は「Amazon BedrockでClaudeから構造化した回答を取得する際に得た知見」です。
目次
はじめに
大規模言語モデル(Large Language Model: LLM)の登場により、アプリケーション開発の可能性は大きく広がりました。チャットボットや文章生成にとどまらず、LLMから得た回答を分析して次のアクションに繋げ、より高度なシステム間連携も可能となってきています。一方で、LLMからの回答は自由度が高く、常に期待したフォーマットで安定して回答を取得することは依然として開発者を悩ませる課題の一つです。特に、システム間連携を行うためのインターフェースがJSONとなっている場合にはLLMにJSON形式の回答をさせる必要があります。
本稿では、私がLLMに関する検証を行った際に同様の課題に直面し、どのように解決したかをまとめます。具体的には、Amazon Bedrockを経由したClaude 3.7 Sonnetを用いたLLMの動作検証を通じ、LLMから安定して構造化した回答を得るために行った解決法と留意点を説明します。
LLMから構造化した回答を得るためのプラクティスは複数存在しますが、ツールの使用をサポートしているLLMで手軽に構造化した回答を得たいケースでは今回紹介するプラクティスを用いることが効果的だと感じました。本稿を通して、LLMから安定して構造化した回答を得ることは意外と難しくないと少しでも感じてもらえると幸いです。
※本稿では、LLMの一般例を説明するためにWebUIを経由したGemini 2.5 Proを使用し、プログラム実装に関する説明ではAmazon BerdockのAPIを経由したClaude 3.7 Sonnetを使用します。
LLMの出力制御は難しい
一般に、LLMの出力はLLMに与える指示(プロンプト)で期待する形を制御します。
例えば、リスト形式で出力して欲しい場合は以下のようにプロンプトを定義します。
LLMの動作について調査を行なっています。
サンプルとなるプロンプトを5つリスト形式で出力してください。
このプロンプトに対する回答は以下の通りです。
はい、承知いたしました。LLM(大規模言語モデル)の動作を調査するためのサンプルプロンプトを5つ提案します。

1.  **情報の抽出と要約**
    * 「[記事のURL]の内容を300字以内で要約し、最も重要なポイントを3つの箇条書きで示してください。」

2.  **創造的なテキスト生成**
    * 「中世の騎士と未来のAIが時空を超えて出会い、協力して世界の危機を救うという短編小説のあらすじを作成してください。」

3.  **プログラミングコードの生成**
    * 「Pythonで、指定されたウェブサイトのタイトルを取得する簡単な関数を書いてください。ライブラリは`requests`と`BeautifulSoup`を使用してください。」

4.  **比較と分析**
    * 「電気自動車(EV)とハイブリッド車(HV)のメリットとデメリットを、コスト、環境への影響、メンテナンスの3つの観点から比較分析してください。」

5.  **アイデアのブレインストーミング**
    * 「地域の活性化を目的とした、高校生が主体となって実施できるユニークなイベントのアイデアを5つ提案してください。」
このように1~5の番号付きリストで回答を得られました。LLM出力した回答は以下のような構成になっています。
ユーザに対する直接の回答(返事やこれからLLMが出力しようとする内容)

太文字の主題つき番号リスト (1.  **情報の抽出と要約**)
 与えたプロンプトに対する具体的な回答 (* 「[記事のURL]の内容を300字以内で要約し...)
この時、本当に欲しい情報は「与えたプロンプトに対する具体的な回答」であり、「太文字の主題付き番号リスト」は補足の情報です。また、「太文字の主題付き番号リスト」にはMarkdownで太文字を表す「**」や「1.」のような番号が含まれており装飾されています。このプロンプトではMarkdownの「*」で表されるリストを意図していたため、意図する回答が得られていないと言うことになります。
プロンプトエンジニアリングが必要
前述の例のように、意図した回答を得るためにはLLMへ渡すプロンプトをタスクに合わせて最適化する必要があります。これをプロンプトエンジニアリングと呼びます。前述の例では「番号はいらないが、Markdownの*で示されるリストで5つのプロンプト例が欲しい」ため、以下のようにプロンプトを修正してみます。
LLMの動作について調査を行なっています。
サンプルとなるプロンプトを5つMarkdownの`*`によるリスト形式で出力してください。
回答はサンプルプロンプトのみを示してください。
## 回答
*
このプロンプトで生成された回答は以下のとおりです。
* 「忘れられた神々の図書館」をテーマにした短編小説の冒頭を書いてください。
* 日本の江戸時代における主要な社会階級とその役割について、中学生にも分かるように説明してください。
* Pythonを使用して、2つのCSVファイルを読み込み、共通のID列を基準に内部結合するコードを生成してください。
* あなたは未来から来たタイムトラベラーです。現代の生活で最も驚いたことは何ですか?その理由も教えてください。
* 以下の英文ニュース記事を日本語に翻訳し、3つの箇条書きで要約してください。
生成される内容の指定はしていないため、前節で示した例と出力内容は異なりますが、フォーマットは意図した形式となっています。今回の例は単純なタスクでしたが、より複雑なタスクでは適切な応答を得るためにより詳細なプロンプトを記載しなければなりません。
また、今回のメインテーマである構造化された応答を得るために、プロンプトへ「JSONで出力するように」明記することは容易に考えられますが、冨永さんの記事でも紹介されているとおり、生成される回答にMarkdownのコードブロックJSONが表示される場合があるなど、意図した結果が得られるとは限りません。
コンテキストサイズの制約
LLMにおけるコンテキストサイズにはモデルごとに上限が定められており、そのコンテキストを超える量をプロンプトとして渡しても超えた部分はモデルの結果生成には使用されません。複雑なタスクをプロンプトエンジニアリングしたプロンプトで行っても、この制約により会話が成立しない場合やコンテキストに含める情報の順序に注意を要する場合があります。構造化した回答を得るためにその構造の説明や単語の説明にコンテキストを消費し、Few-shotのような例示を含めたプロンプトの使用が難しくなります。
構造化した回答の取得方法
LLMが使用するツールの入力スキーマを回答として使う
今回は前述の課題を回避しつつLLMでJSONのような構造化された出力を得るためにLLMが使用するツールの入力スキーマを回答として使用する手法を採用しました。これはLLMがサポートする「ツールの使用」を利用しています。ここでのツールとは、LLMが回答を生成する際に何らかの処理を行うための道具(ツール)を指します。例えば、2025年8月6日現在、AnthropicはBashを実行するツールなどを提供しています。AnthropicのAPIコールでツールを使用するためには最小の設定で以下のようなリクエストパラメータの定義を行います。
{
"model": "<LLMのモデル名>",
"tools": [
{
"name": "<ツールの名称>",
"description": "<ツールの説明>",
"input_schema": {
"type": "<ツール入力全体の型>",
"properties": {
"<プロパティ名>": {
"type": "<プロパティの型>",
"description": "<プロパティの説明>",
},
// ...
},
},
}
],
"messages": [
{
"role": "user", // ユーザープロンプトを示す識別子
"content": "<ユーザープロンプト>",
},
],
}
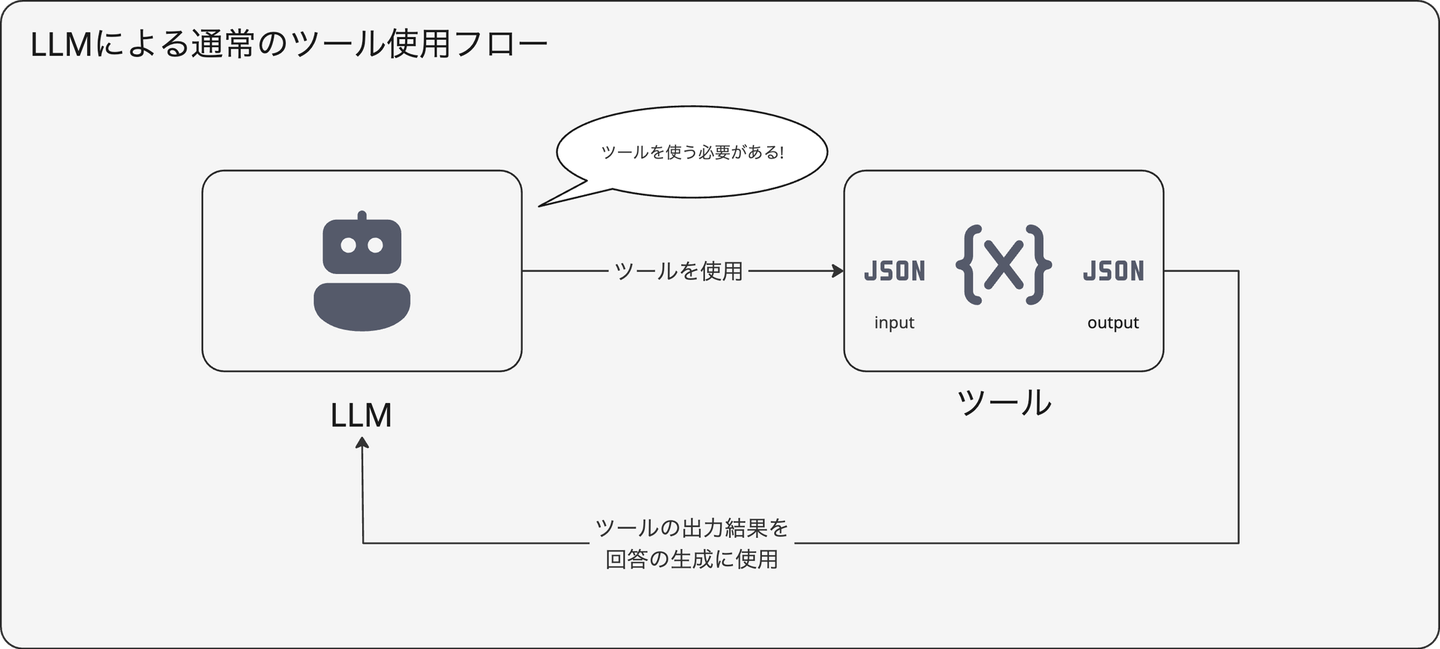
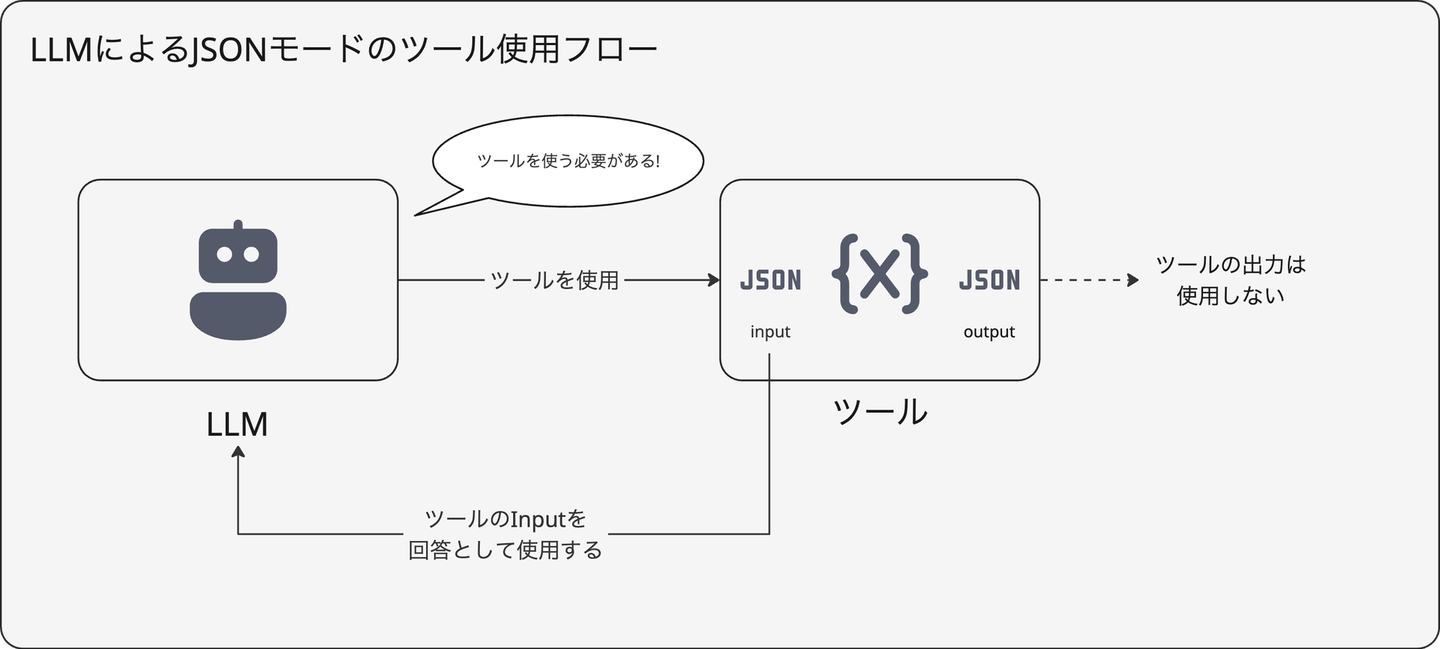
通常、定義したツールの結果を使用してLLMの回答を生成します。一方で、JSONモードではinput_schemaに定義されたJSON構造をLLMの出力として使用します。このモードはLLMがツールを使用する際にinput_schemaで定義されている構造へLLMが回答を整形するため機能しています。図解すると以下のようになります。
Amazon Bedrockにおける解決の方法
Converse APIを使用する
Amazon Bedrockでモデルのツール使用を行うにはConverse API (ストリーミング処理を行う場合はConverseStream API)を使用します。Converse APIは複数のモデルに対して統一したインターフェースでコールできることが特徴のAPIです。また、過去のユーザーとLLMの会話をリクエストパラメータに含めることも可能です。なお、Amazon BedrockがサポートするすべてのLLMがツール使用できるわけではなく、Anthropic ClaudeやAmazon Nova、Meta Llamaなどサポートされているモデルが決まっています。詳しくはAWSのドキュメントを参照ください。
toolConfigパラメータに欲しい回答の構造を定義する
ツールを使用して構造化したデータを得るためにはリクエストパラメータのtoolConfigで指定します。以下にboto3を使用したPythonでの実装例を示します。
import json
import boto3
bedrock_client = boto3.client("bedrock-runtime", region_name="us-east-1")
model_id = "us.anthropic.claude-3-7-sonnet-20250219-v1:0"
user_message = "LLMの動作について調査を行なっています。サンプルとなるプロンプトを5つリスト形式で出力してください。"
conversation = [
{
"role": "user",
"content": [{"text": user_message}],
}
]
inference_config = {
"maxTokens": 512,
"temperature": 0.5,
"topP": 0.9
}
tool_config = {
"tools": [
{
"toolSpec": {
"name": "prompt_responser",
"description": "与えられた複数のプロンプトに対する回答を生成するツール",
"inputSchema": {
"json": {
"type": "object",
"properties": {
"prompts": {
"type": "array",
"minItems": 1,
"items": {
"type": "string",
},
},
},
"description": "回答を得たいプロンプトの一覧",
}
},
},
},
],
}
response = bedrock_client.converse(
modelId=model_id,
messages=conversation,
inferenceConfig=inference_config,
toolConfig=tool_config,
)
# 動作確認のためにマジックナンバーを使用、
# 本来はresponse["output"]["message"]["content"]を
# ループさせてそれ以降を取得すべき
tool_input = response["output"]["message"]["content"][1]["toolUse"]["input"]
print(json.dumps(tool_input, ensure_ascii=False, indent=2))
上記の例は「LLMの出力制御は難しい」節の冒頭で挙げた例と同じプロンプトで実装しました。converse APIのtoolConfigで架空の回答生成ツールを定義しています。架空のツールで良い理由は前述の通りツールの出力を使用しないためです。また、InputSchemaにはJSON Schemaに準拠した期待するツールのinputが定義されています。JSON Schemaでは型や最小出力数、説明などを含めることができるため、出力として欲しいデータの形をそのまま表現することができます。この実装の実行結果は以下の通りとなります。
{
  "prompts": [
    "あなたは優秀な文章校正者です。以下の文章を日本語の文法や表現を改善して校正してください。「私は昨日デパートに行って、新しい服を買いました。とても気に入っていて嬉しいです。」",
    "AIの倫理的な問題点について、賛成と反対の両方の立場から500字程度で論じてください。",
    "次の数学の問題を解いてください:2次方程式 x² - 5x + 6 = 0 の解を求めよ。",
    "「持続可能な開発」という概念について説明し、現代社会における具体的な取り組み例を3つ挙げてください。",
    "以下の英文を自然な日本語に翻訳してください:'Artificial intelligence has made significant progress in recent years, transforming various industries and changing the way we live and work.'"
  ]
}
留意点
ツールの説明にはそのツールの使い方を記載する
ツールの説明を記載するdescriptionには、欲しい構造化された出力の説明ではなくツール自体の説明を記載します。これは、ツールを使うかどうかはLLMが実行時に判断し、複数のツールが指定されている場合にどのツールを使うかの判断に使用されるためです。誤って欲しいデータの説明をすると一向にツールが使用されず回答が出力されないといった事象が発生します。
モデルがinputをツールに渡すことを覚えておいてください。そのため、ツールの名前と説明はモデルの視点からのものである必要があります
- Claudeでのツール使用 - Anthropic
モデルにツールの使用を強制させる
ツール使用の判断はLLMに渡されるコンテキストに委ねられていますが、必ず定義したツールを使用して欲しい場合はリクエストパラメータのtoolChoiceにtoolsのtoolSpecで定義したツール名を指定することでそのツールの使用を強制することができます。以下の実装例では前述のツール(prompt_responser)の使用を強制します。
# ...
tool_config = {
"tools": [
{
"toolSpec": {
"name": "prompt_responser",
"description": "与えられた複数のプロンプトに対する回答を生成するツール",
"inputSchema": {
"json": {
"type": "object",
"properties": {
"prompts": {
"type": "array",
"minItems": 1,
"items": {
"type": "string",
},
},
},
"description": "回答を得たいプロンプトの一覧",
}
},
},
},
],
"toolChoice": {
'tool': {
'name': 'prompt_responser'
}
},
}
response = bedrock_client.converse(
modelId=model_id,
messages=conversation,
inferenceConfig=inference_config,
toolConfig=tool_config,
)
# 動作確認のためにマジックナンバーを使用、
# 本来はresponse["output"]["message"]["content"]を
# ループさせてそれ以降を取得すべき
tool_input = response["output"]["message"]["content"][0]["toolUse"]["input"]
print(json.dumps(tool_input, ensure_ascii=False, indent=2))
// 出力結果
{
  "prompts": [
    "LLMの基本的な仕組みについて説明してください。",
    "テキスト生成における温度パラメータの役割とその効果を教えてください。",
    "プロンプトエンジニアリングの重要性と効果的な手法について解説してください。",
    "LLMのファインチューニングとは何か、どのような場合に有効なのか説明してください。",
    "LLMのハルシネーション(幻覚)問題とその対策方法について教えてください。"
  ]
}
ツールのスキーマに定義する用語の説明は詳細に記載する
ツールのスキーマには複数の許容する選択肢をenumとして定義することができます。一方で、enumで定義された単語の意味が曖昧だと正しい回答が得られません。そこで、enumの単語と説明をdescriptionに記載することでLLMが正しい判断をするように促すことができます。
INPUT_SCHEMA = {
"json": {
"type": "object",
"properties": {
"responses": {
"type": "array",
"items": {
"type": "string",
"enum": [
"大丈夫です",
"適当です",
"結構です",
],
},
"description": """
応答する際の選択肢。
大丈夫です: 問題ないことの意
適当です: 適切であることの意
結構です: 不要・遠慮することの意
""",
},
},
},
}
上記の例ではすべてポジティブにもネガティブにも捉えられる単語です。LLMは与えられたコンテキストに依存して回答が生成されるため、意図した回答が得られるように解きたいタスクに即した用語の説明を行うことが重要です。
まとめ
本稿では、LLMに関する検証を行った際に直面した構造化した回答の取得に関する課題の解決法と付随する知見についてまとめました。Amazon BedrockではConverse APIを用いてツール使用による構造化した回答の取得が簡単に得られることがわかりました。同様の課題を感じている方の助けとなれば幸いです。
参考文献

Claudeでのツール使用 - Anthropic
Converse


/assets/images/7052304/original/49100b17-5866-4cec-b50b-a37ea73565e9?1638782149)