メディフォンでフロントエンドエンジニアをしている阿部です。企業や自治体で働く人の健診結果やストレスチェックなどを扱うクラウド型健康管理システム「mediment」の開発に携わっています。
「なるべく自分でコードを書くな」
2026年2月、プロダクトマネージャーからこう言われました。
> なるべく自分でコードを書かず、Claudeに書かせるように
AIコーディングの本格導入です。
自分は普段、VueとTypeScriptを書いています。バックエンドは以前PHPのフレームワークを触っていた時期がありますが、直近で書いたのは数年以上前。medimentで使われているPythonはほぼ触ったことがありません。AIコーディングも始めたばかりで、当時はClaudeに部分的なコードやテストを書かせ、Copilotをコード補完とPRレビューに使う程度でした。
それから半年。DBのフィールド追加を含むバックエンドのタスクを、複数のPRに分割して出せるところまで来ました。当初はAIさえあれば初学者でも業務に耐えうるコードが書けると考えていましたが、その過程は決して簡単ではありませんでした。
AIで何ができて何ができなかったのか。この半年で学んだことについて書いていきます。
AIにコードを書かせるところから始まった
年明け過ぎから、Bootstrapのバージョン移行作業をしていました。その中で、差分を比較したり確認すべきURLを洗い出したりするPython製の補助ツールがあり、このツールのアップデートをきっかけにAIコーディングを本格的に使い始めました。
補助ツールについて詳しくは岩渕さんのブログをご覧ください。
AIのおかげで「割に合わなかったこと」が実行できるようになった-Bootstrap移行のビジュアルリグレッションテスト環境を構築した話|メディフォン株式会社【公式】
当時はPythonのコードを十分に理解していませんでした。それでもAIにコードを書かせ、動かして確認するという進め方はできました。ここで「AIにコードを書かせる」感覚を掴みました。
またこのとき「テストがあれば防げる」という安心感もありました。AIにテストを書かせると基本的なケースはしっかり押さえられていることが多く割と信頼していたのです。ただこの考えは後のバックエンド開発で少しずつ変わっていきます。
バックエンド本格開発開始
フロントとバックエンドの軽いタスクをいくつかこなした後、5月からフロントエンドとバックエンドにまたがる機能を担当することになりました。APIを新しく作りDBのフィールドを追加する機能です。影響範囲が広く複数のPRに分けて出す必要があります。バックエンド開発を進める上でマイグレーション周りは避けて通れませんが、バックエンドエンジニアがしっかりレビューしてくれるとのことで取り組んでみることにしました。
そしてここではいろいろと指摘を受けました。
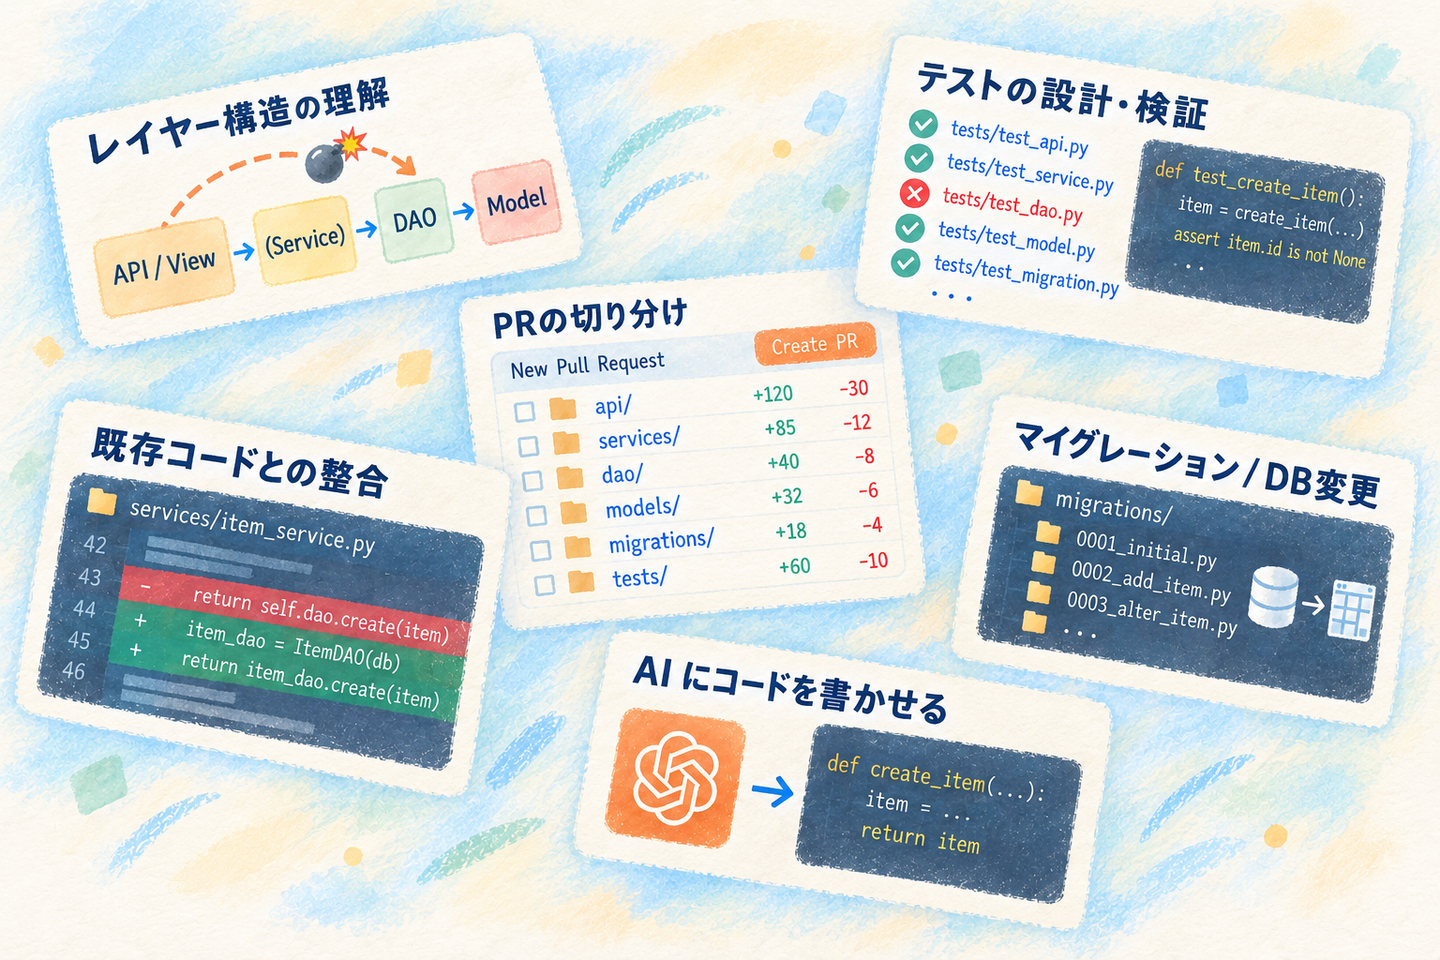
medimentには、API / View → (Service) → DAO → Modelというレイヤー構造があります。当時はこれを十分に理解できておらずコードを置く場所を間違えたり、API / Viewから不適切な形でDAOを呼んでいるのを見抜けなかったりしました。PRの切り分け方も適切な形が見えておらず、ServiceやDAO、マイグレーションを他の作業と混ぜて大きなPRにしてしまい分割して出し直すことに。AIにコードを書かせること自体はできても、どこに置き、どの粒度で分け、既存の設計にどう合わせるかという判断は、別の問題でした。
テストへの認識も変わりました。AIはもっともらしい誤りを生成することがあり、テスト自体が不完全で落ちるべきパターンを通してしまったこともありました。「テストがあるから大丈夫」ではなく、そのテストが本当に検証したいことを検証できているかを見る必要がある。任せれば品質まで保証されるわけではないと実感しました。
最初のPRについて、レビュアーからは
> medimentのバックエンド開発の基本セオリー部分が、うまくコードに落とし込めていない印象を受けた
その後、終盤には
> かなり短期間で他のコードと遜色ない品質になった
とも言ってもらえました。ただ「設計の綺麗さみたいな感覚はまだ厳しそう」とも言われ、ここはAIに書かせるだけでは埋まらない部分だと感じています。
チームで共有するAIと、自分だけのAI
Claude Codeでは、設定ファイルであるCLAUDE.mdを使って、プロジェクト固有のルールをAIに読ませられますが、medimentでは、これをgit管理下に置いてチームで共有しています。コーディング規約、ディレクトリ構成、レイヤー分割の原則、テストの実行方法など、人間向けのオンボーディング資料が、そのままAI向けの指示書になっている状態です。
その上に、各自がgit管理外の個人用CLAUDE.mdやMemory、繰り返す作業を手順化したスキルを重ねています。設定の濃さは人それぞれで、自分は多めに書き込む方です。AIはコードを書く以外にも、作業の方向性の相談や修正箇所の洗い出し、作業報告のまとめなど、多方面で使っています。
個人設定を育てる途中でも問題がありました。AIは時折ハルシネーション(もっともらしい嘘)を起こします。再発を防ぐため、起きるたびに原因を徹底的に追及し、AI自身にも、ハルシネーションを起こしたら何がトリガーだったのかを徹底的に自己監視するよう認識させていました。
しばらくすると様子がおかしくなり、ファビュレーション(記憶の抜け落ちた部分を、嘘の情報で埋めてしまう現象)が頻繁に起きるようになりました。存在しない会話を「さっき合意した」という体で持ち出し、それを根拠に勝手に作業を進めるのです。実作業に支障が出るレベルでした。
AI本人に相談したところ、ハルシネーションを起こすことを強く認識させると「自分はハルシネーションを起こす存在だ」という自己認識が形成され、かえって悪化する可能性があると示唆されました。Memoryの掃除も試しましたが改善せず、最終的には、たまたま残っていた追及前のワークスペースのバックアップに戻しました。これは自分の環境で起きた一例で、因果は検証できていません。
バックエンド2本目
またいくつか小さなタスクをこなした後、2つの機能を並行して実装する案件に取り組みました。そのうち1つは、データを読むだけのAPIを1本追加するものでしたが、レビュアーから複数の指摘がつきました。PRの切り分けやレイヤー配置はなんとなく分かってきていたものの、書かれているのがDAOの呼び出しだと気付けず、以前受けた配置ミスの指摘を十分活かしきれていませんでした。余計な型設定やガード不足、既存処理の使い方などの指摘もありました。
この経験を踏まえ、PRを出す前のセルフレビューを見直しました。現在は、独立したコンテキストで動く3本のスキルに、異なる観点から差分を確認させています。
/code-review:バグ、正確性、再利用、簡潔化、効率
/security-review:セキュリティ
/my-review-lens(自作):過去に受けた指摘との照合
自作の/my-review-lensは、過去のレビュー指摘をチェックリストとして蓄積するスキルです。ここで意識したのは、できるだけAIの解釈に頼らず、客観的に確認できる形にすることでした。
たとえば「業務ロジックはServiceに置く」だけでは、目の前のコードが業務ロジックかどうかをAIが判断する必要があり、「これは業務ロジックではないので問題ない」と実際とは違う結論に至ることもあります。そこで、レイヤーをまたいだ呼び出しなら「そこに現れるはずのないメソッド名」を直接指定する形にしました。特定の文字列がその層に出現しているかは、検索するだけで分かります。「コメントは簡潔に」も「2行以上になっていないか」と数えられる条件に置き換えました。AIに判断させるだけでなく、AIが間違えにくいチェックの仕組みを作る。この部分は、使い続ける中で大きく変わりました。
一方で、前回より改善されたこともありました。レビュアーからは、
> PRの構造は良くなった。コミットが層ごとに分かれていて、1コミット1意図が守られている。フロントエンドを後続のPRに回してバックエンドだけに絞ってあるのもレビューしやすい
> テストを書いていても気づきにくく、AIに任せると一番落ちやすいようなセキュリティまわりの境界も守れている
という評価をもらいました。6月にPRの切り分けについて指摘されたことが、ようやく形になってきた感じです。一方で、たとえば共通のデータ取得処理で絞り込み条件をコメントで示すのか引数で強制するのか、といった「どこまでを仕組みとして強制するか」の判断は、まだ難しいところです。
半年のAIコーディングの果てに
良くなったと言われたのはPRの構造で、まだ難しいと言われたのは設計判断でした。
フロントエンドなら、これまでの経験から設計の良し悪しを判断できます。共通コンポーネントに幅を直接設定すると扱いにくくなるので親からpropsで渡せるようにする、選択情報を各選択対象オブジェクトに埋め込むと大量処理が重くなるので別管理にする。散々やってきた領域なので、判断の軸があります。ですがバックエンドでは、設計の構造や意図を理解できないこともあり、AIが出したものが妥当かどうかも分かりません。
判断の軸は、その領域の知識と、何度も判断して正解も失敗もした経験の量で作られます。AIによって知識は一気に広がりますが、経験は短期間では埋まりません。設計判断は、経験を積んだレビュアーに支えてもらっています。
自分はAIのハンドラーとして、レビュアーが判断しやすい形でPRを出すことに注力し、PRの構造やコミットの粒度、本文の精度は向上しました。一方で設計判断では、エンジニアとしての実力がそのまま問われます。AIが書いたコードを、AIを使う人間がレビューする——この構図で何をAIに任せ、何を自分で担うべきか、まだ明確な答えはありません。
それでも、ひとつ見えてきたことがあります。バグの発見や、決められたルールへの適合確認は、これからどんどんAIに任せやすくなると思いますが、設計の筋が通っているか、PRの構造が適切か、テストが検証したいことを本当に検証できているか、読み手に理解しやすい形か——言語化しにくく経験に依存する部分は、まだ人間の仕事として残っています。
この半年は、「AIにコードを書かせる方法」を覚える期間ではなく、「AIに任せられるもの」と「自分が判断すべきもの」の境界が少しずつ見えてきた期間でした。AIがコードを書くのが当たり前になるほど、その境界を判断できるエンジニアの重要性は増していくのだと思います。AIで速度を上げつつ、設計やレビューでは人間の経験と判断を持ち寄る。最終的な品質の担保は人が持つ。その意識を、今回の開発で新たにしました。これからもAIに任せる範囲を広げながら、自分の判断できる領域も少しずつ広げていきたいと思います。